Migración de LLM en producción: cambia de provider sin romper tu agente
Llevas doce meses sobre un provider. Lo conoces bien, tienes tu stack afinado, el agente funciona. Entonces algo cambia: los costes suben, hay un modelo mejor en otro provider, el equipo quiere aprovechar funcionalidades que tu proveedor actual no tiene. Decides migrar.
Copias el cliente, adaptas los parámetros, despliegas. Y el agente que llevaba un año funcionando empieza a comportarse diferente, a seleccionar mal las herramientas o a fallar en casos que antes no daban ningún problema.
El problema no es la calidad del nuevo provider. Es que cada uno habla un dialecto distinto y nadie te advirtió de los detalles que importan en producción.
Por qué las APIs de LLM no son intercambiables
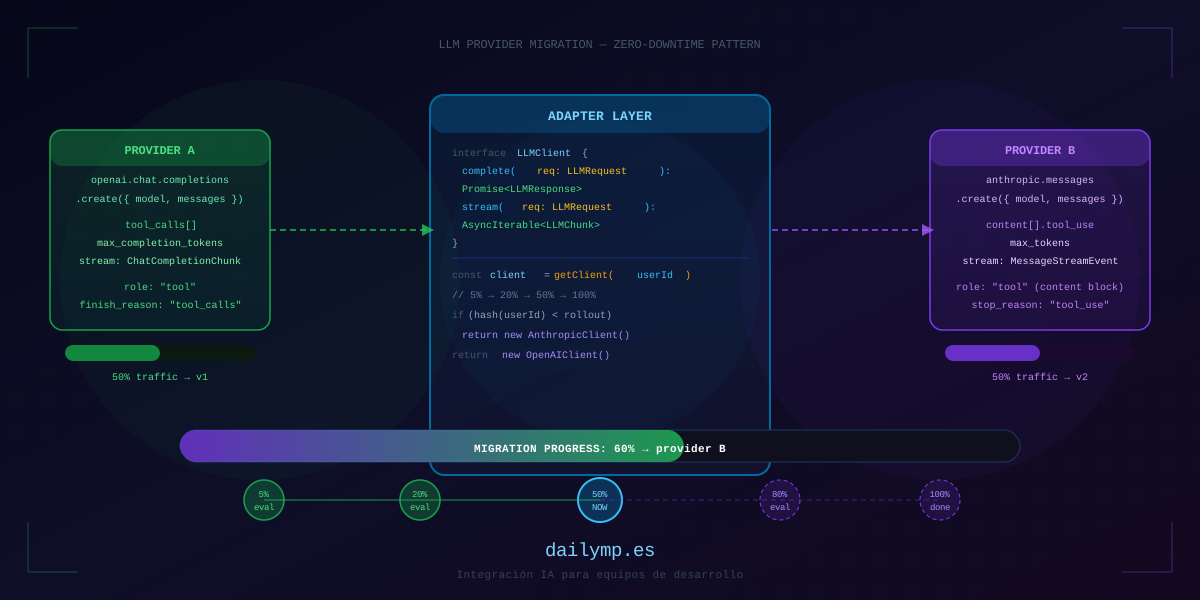
A nivel de documentación parece sencillo: ambos providers reciben mensajes y devuelven respuestas. En producción, las diferencias son mucho más sutiles:
Formato de tool calling:
- OpenAI:
finish_reason: "tool_calls", respuesta enmessage.tool_calls[] - Anthropic:
stop_reason: "tool_use", respuesta encontent[]como bloques de tipotool_use
Parámetro de tokens:
- OpenAI:
max_completion_tokens(el antiguomax_tokensestá deprecado) - Anthropic:
max_tokens(requerido, sin valor por defecto)
Formato de streaming:
- OpenAI: eventos
ChatCompletionChunkcon delta acumulativo - Anthropic: eventos
content_block_deltacon índice explícito de bloque
Resultados de tool use:
- OpenAI: mensaje de rol
toolcontool_call_id - Anthropic: bloque de contenido
tool_resultdentro de un mensaje de usuario
Cualquiera de estas diferencias, si la pasas por alto, produce fallos que no lanzan excepciones pero que sí rompen la lógica del agente silenciosamente.
El patrón: capa de abstracción + migración gradual
La solución que usamos en los proyectos de integración de agentes IA de DAILYMP tiene dos partes: una interfaz común que abstrae las diferencias, y un router de tráfico que mueve usuarios gradualmente al nuevo provider.
Paso 1: define una interfaz agnóstica de provider
// lib/llm/types.ts
export interface LLMRequest {
  messages: Message[];
  tools?: ToolDefinition[];
  maxTokens?: number;
  temperature?: number;
  systemPrompt?: string;
}

export interface LLMResponse {
  content: string;
  toolCalls?: ToolCall[];
  stopReason: 'end_turn' | 'tool_use' | 'max_tokens';
  usage: { inputTokens: number; outputTokens: number };
}

export interface LLMClient {
  complete(req: LLMRequest): Promise<LLMResponse>;
  stream(req: LLMRequest): AsyncIterable<LLMChunk>;
}
Paso 2: implementa un adapter por provider
Cada adapter traduce tu interfaz común al formato nativo del provider. El código que llama al LLM nunca importa el SDK directamente — solo usa LLMClient.
// lib/llm/anthropic-client.ts
export class AnthropicClient implements LLMClient {
  private client = new Anthropic();

  async complete(req: LLMRequest): Promise<LLMResponse> {
    const res = await this.client.messages.create({
      model: 'claude-sonnet-4-6',
      max_tokens: req.maxTokens ?? 4096,
      system: req.systemPrompt,
      messages: req.messages.map(adaptMessageToAnthropic),
      tools: req.tools?.map(adaptToolToAnthropic),
    });

    return {
      content: extractTextContent(res.content),
      toolCalls: extractToolCalls(res.content),
      stopReason: mapStopReason(res.stop_reason),
      usage: { inputTokens: res.usage.input_tokens, outputTokens: res.usage.output_tokens },
    };
  }
}
El adapter de OpenAI sigue la misma estructura pero habla el dialecto de OpenAI. Tu agente no cambia una sola línea cuando cambias de provider.
Paso 3: router de tráfico con rollout gradual
No cambias el 100% del tráfico de golpe. Empiezas con el 5%, observas los evals y métricas, y vas subiendo:
// lib/llm/router.ts
export function getLLMClient(userId: string): LLMClient {
  const rolloutPercent = getFeatureFlag('llm_provider_b_rollout'); // 5 → 20 → 50 → 100
  const bucket = hashUserId(userId) % 100;

  if (bucket < rolloutPercent) {
    return new AnthropicClient();
  }
  return new OpenAIClient();
}

// En tu handler de agente:
const llm = getLLMClient(session.userId);
const response = await llm.complete(request);
Con hashUserId determinista, el mismo usuario siempre va al mismo provider durante todo el rollout. Esto es importante para mantener coherencia en conversaciones multi-turno y para que los usuarios no experimenten comportamientos inconsistentes.
Los tres gotchas que nadie documenta
1. Los tool names deben ser únicos y sin espacios
Anthropic es más estricto aquí que OpenAI. Si tienes tools con nombres como "get customer data" (con espacio), Anthropic las rechaza con un 400. Valídalos antes de empezar.
2. El system prompt de Anthropic va en un campo separado
En OpenAI, el system prompt es un mensaje con role: "system" dentro del array de mensajes. En Anthropic es el campo system del objeto principal. Tu adapter tiene que extraerlo correctamente o el agente ignora las instrucciones del sistema.
3. Los mensajes de usuario y asistente deben alternarse
Anthropic valida estrictamente que los mensajes alternen entre user y assistant. Si tienes dos mensajes de usuario consecutivos (algo que OpenAI permite), la migración falla inmediatamente. Normaliza el historial en el adapter.
Cuándo ejecutar los evals de validación
En la migración gradual, los evals son la puerta de entrada a cada fase. Antes de pasar del 5% al 20%, corres el eval suite completo sobre los usuarios del 5% y validas que el score no haya caído. Si cae, reviertes el rollout a 0% en segundos.
Para un agente de producción bien instrumentado, la migración completa entre providers suele tomar entre dos y tres semanas a este ritmo. Es un proceso aburrido, lento y casi sin incidentes. Exactamente como debería ser.
Por qué hacerlo bien desde el principio
Si ya tienes un agente en producción sin capa de abstracción, tienes deuda técnica que va a cobrarte en el peor momento. La siguiente vez que un provider suba precios, deje de dar soporte a una versión de API o simplemente salga un modelo mejor en otro sitio, tendrás que reescribir el núcleo del sistema en lugar de cambiar una línea de configuración.
En los proyectos que montamos en DAILYMP este patrón va incluido desde el día uno. No como una decisión de arquitectura exótica — como higiene básica de un sistema que va a vivir en producción durante años.
Si tienes un agente corriendo sobre un provider y estás pensando en una migración, o si quieres revisar si tu arquitectura actual soporta un cambio sin coste en el futuro, hablamos.