Feedback loops en agentes IA: mejora sin reentrenar
Tu agente lleva tres semanas en producción. Los primeros días funcionó bien. Luego empezaron los "esto está mal" de los usuarios. Ajustaste el system prompt. Redesplegaste. Una semana después, los mismos errores reaparecieron en una variante ligeramente diferente.
Hay un patrón aquí que la mayoría de equipos no resuelve bien: el system prompt es estático y los errores son dinámicos. Puedes refinar el prompt cada semana, pero nunca tendrás suficientes ejemplos ahí dentro para cubrir todos los casos que aparecen en producción. Y el fine-tuning es demasiado lento, caro y requiere cientos de ejemplos curados.
Existe una solución intermedia que casi nadie implementa: un feedback loop basado en embeddings que convierte cada corrección de usuario en un few-shot dinámico.
El problema raíz: tus ejemplos no escalan
El few-shot funciona. Ya lo cubrimos en el artículo sobre few-shot en producción: dar tres ejemplos concretos al modelo supera a 500 palabras de instrucciones.
El problema es que esos ejemplos son estáticos. Los escribes tú, una vez, en el system prompt. No cambian cuando un usuario dice "eso está mal".
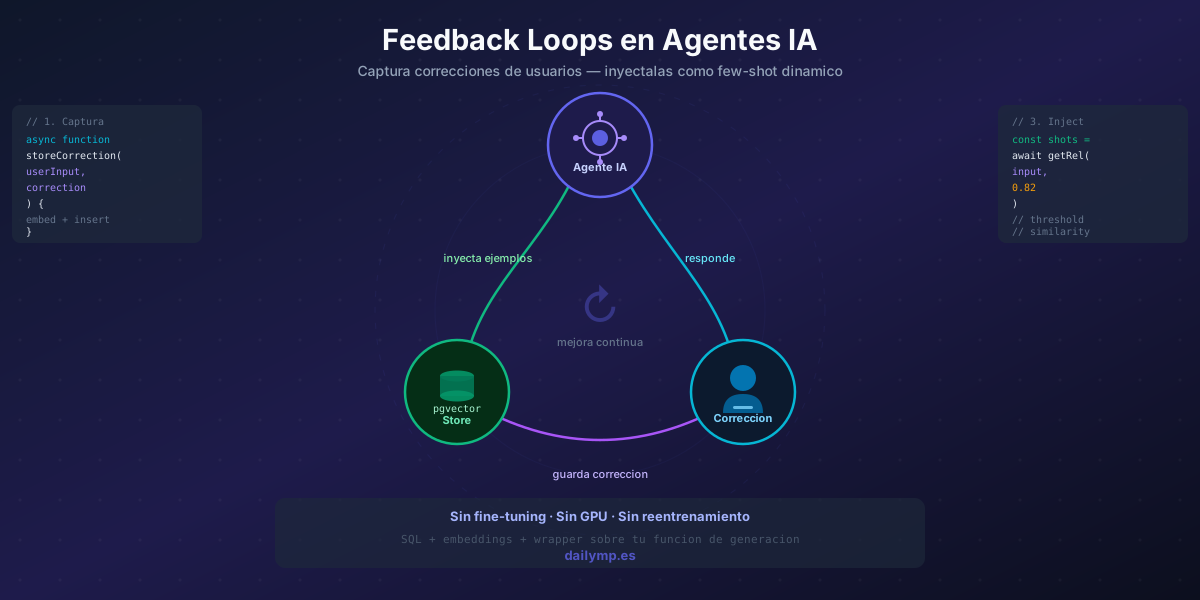
El feedback loop cierra ese ciclo: en vez de que tú actualices el prompt manualmente, el sistema captura las correcciones de los usuarios y las convierte automáticamente en nuevos ejemplos, recuperados por similitud semántica cuando llega una consulta parecida.
No es fine-tuning. No hay GPU. No hay reentrenamiento. Es SQL + embeddings + un wrapper sobre tu función de generación.
La arquitectura en tres piezas
El sistema tiene tres componentes:
1. Endpoint de captura. El frontend envía la corrección del usuario: el input original, la respuesta del agente y la respuesta correcta. Un endpoint POST lo procesa, genera el embedding del input y lo almacena.
2. Tabla de correcciones. Una tabla en Supabase con el trío (user_input, agent_output, correction) más la columna vectorial input_embedding para búsqueda por similitud.
3. Wrapper de inyección. Antes de cada llamada al LLM, recuperas las correcciones más similares al input actual y las añades al system prompt como ejemplos con etiquetas XML claras.
Implementación paso a paso
La tabla y la función de búsqueda
CREATE TABLE agent_corrections (
  id           uuid DEFAULT gen_random_uuid() PRIMARY KEY,
  user_input   text NOT NULL,
  agent_output text NOT NULL,
  correction   text NOT NULL,
  input_embedding vector(1536),
  approved     boolean DEFAULT true,
  use_count    integer DEFAULT 0,
  created_at   timestamptz DEFAULT now()
);

CREATE INDEX ON agent_corrections
  USING ivfflat (input_embedding vector_cosine_ops)
  WITH (lists = 50);

CREATE OR REPLACE FUNCTION match_corrections(
  query_embedding vector(1536),
  match_threshold float,
  match_count int
)
RETURNS TABLE (
  user_input text, agent_output text, correction text, similarity float
)
LANGUAGE sql STABLE AS $$
  SELECT user_input, agent_output, correction,
         1 - (input_embedding <=> query_embedding) AS similarity
  FROM agent_corrections
  WHERE approved = true
    AND 1 - (input_embedding <=> query_embedding) > match_threshold
  ORDER BY similarity DESC
  LIMIT match_count;
$$;
El endpoint de captura
// app/api/feedback/route.ts
import { embed } from '@/lib/embeddings';
import { createClient } from '@/lib/supabase-server';

export async function POST(req: Request) {
  const { userInput, agentOutput, correction } = await req.json();

  const embedding = await embed(userInput);
  const supabase = createClient();

  await supabase.from('agent_corrections').insert({
    user_input: userInput,
    agent_output: agentOutput,
    correction,
    input_embedding: embedding,
  });

  return Response.json({ ok: true });
}
El wrapper de inyección
// lib/agent-with-feedback.ts
import { embed } from './embeddings';
import { supabase } from './supabase';

async function getRelevantCorrections(userInput: string) {
  const embedding = await embed(userInput);
  const { data } = await supabase.rpc('match_corrections', {
    query_embedding: embedding,
    match_threshold: 0.82,
    match_count: 3,
  });
  return data ?? [];
}

export async function buildPromptWithFeedback(
  basePrompt: string,
  userInput: string
): Promise<string> {
  const corrections = await getRelevantCorrections(userInput);
  if (corrections.length === 0) return basePrompt;

  const block = corrections
    .map(
      (c) => `
<correccion>
<input_usuario>${c.user_input}</input_usuario>
<respuesta_incorrecta>${c.agent_output}</respuesta_incorrecta>
<respuesta_correcta>${c.correction}</respuesta_correcta>
</correccion>`
    )
    .join('');

  return `${basePrompt}\n\n<correcciones_previas>${block}</correcciones_previas>`;
}
El threshold de 0.82 es conservador: solo inyecta correcciones muy similares al input actual. Si las correcciones no se están usando, bájalo a 0.78. Si se inyectan correcciones irrelevantes, súbelo a 0.86. Empieza alto y ajusta con datos reales.
Qué vigilar para que no se convierta en un problema
Contradicciones. Si dos usuarios corrigen el mismo tipo de error de formas opuestas, inyectar ambas confunde al modelo. Añade una columna conflicted y un proceso de revisión para detectarlas antes de marcarlas como approved.
Envenenamiento del prompt. Para agentes de uso público, un usuario puede intentar enviar correcciones maliciosas diseñadas para alterar el comportamiento. La columna approved existe exactamente para esto: por defecto en false, con un paso de revisión antes de activarlas.
Budget de tokens. Cada corrección añade ~150 tokens al contexto. Con tres correcciones como máximo y un threshold alto, el impacto es manejable. Para conversaciones largas, prioriza usando use_count — las correcciones más reutilizadas primero.
Métricas que importan
Antes de este sistema, no sabes cuánto mejora tu agente. Con él, tienes tres métricas accionables:
- Tasa de corrección reutilizada: ¿cuántas veces se usa cada corrección antes de que el error deje de aparecer? Si una corrección nunca se reutiliza, el agente ya dejó de cometer ese error.
- Tasa de aceptación del feedback: % de interacciones que el usuario no marca como incorrectas.
- Tiempo medio hasta la mejora: cuántas interacciones pasan después de guardar una corrección hasta que ese tipo de error desaparece del tráfico.
Si esto lo conectas a un sistema de observabilidad del agente, puedes ver la mejora en tiempo real en el dashboard.
Cuándo este sistema no es suficiente
El feedback loop es táctico: corrige errores uno a uno a medida que aparecen. Funciona bien hasta que acumulas 200–300 correcciones en la misma categoría de error, lo que indica un problema sistémico en el prompt base o en la arquitectura del agente.
En ese punto, es señal de revisar la integración IA desde arriba o de evaluar si tienes suficientes datos para que el fine-tuning sea rentable. Por debajo de ese umbral, el feedback loop es más rápido y más barato que cualquier alternativa.
Implementarlo en tu agente
Si tienes un agente en producción que sigue cometiendo los mismos errores, este patrón tarda menos de un día en implementar sobre una arquitectura Next.js + Supabase existente.
Si quieres que lo construyamos nosotros, o si necesitas adaptar el sistema a tu stack actual, escríbeme: