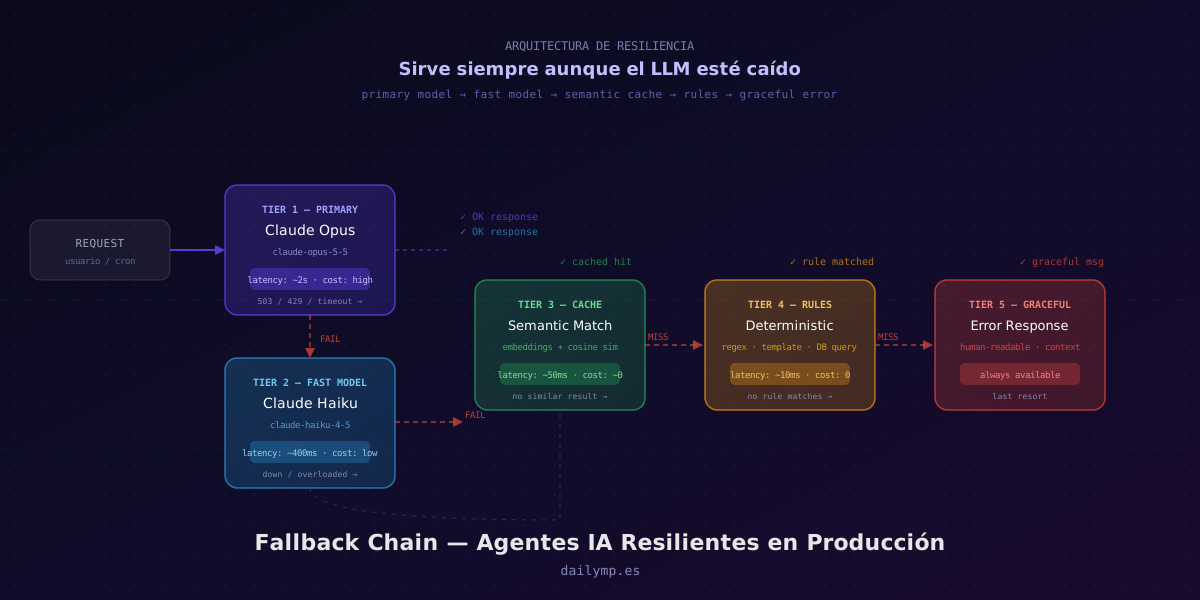
Cadenas de Fallback en Agentes IA: Sirve Siempre
El circuit breaker se abrió. Después de cuatro reintentos con backoff exponencial, tu agente decidió que la API del LLM no está respondiendo. La lógica de reintento funciona exactamente como diseñaste.
¿Y ahora qué?
Si tu agente lanza una excepción y la interfaz muestra un error genérico, has resuelto el problema técnico pero has destruido la experiencia. El circuit breaker resuelve cuándo parar de intentarlo. La cadena de fallback resuelve qué sirves después.
Son dos patrones distintos. Este artículo cubre el segundo.
Por qué el fallback no es "mostrar un error"
Hay una diferencia entre un sistema que falla y un sistema que degrada.
Un sistema que falla devuelve un error cuando no puede hacer lo que le pides. Un sistema que degrada devuelve la mejor respuesta posible dado el contexto actual, aunque sea una respuesta menos precisa, más lenta o generada por un mecanismo diferente.
En producción, un agente que degrada elegantemente tiene un SLA radicalmente mejor que uno que no tiene fallback. No porque falle menos, sino porque cuando falla, sigue sirviendo algo útil.
La mayoría de equipos que usan agentes IA en producción tienen implementado el retry y el circuit breaker (o algo parecido), pero pocas veces tienen definida la jerarquía de lo que viene después. Eso es lo que construimos aquí.
La estructura de una cadena de fallback
Una cadena de fallback es una secuencia de mecanismos ordenados por calidad descendente y disponibilidad ascendente. Cuando el primero falla, pruebas el segundo. Cuando el segundo falla, el tercero. El último siempre responde.
type FallbackTier = {
  name: string;
  execute: (input: AgentInput) => Promise<AgentOutput>;
  isAvailable: () => Promise<boolean>;
};

async function withFallbackChain(
  input: AgentInput,
  tiers: FallbackTier[]
): Promise<AgentOutput & { tier: string }> {
  for (const tier of tiers) {
    const available = await tier.isAvailable().catch(() => false);
    if (!available) continue;

    try {
      const result = await tier.execute(input);
      return { ...result, tier: tier.name };
    } catch {
      continue;
    }
  }

  // El último tier nunca falla: respuesta mínima siempre disponible
  return buildGracefulError(input);
}
La cadena típica para un agente de soporte o extracción tiene cuatro niveles:
Tier 1 — Modelo primario: El mejor modelo que tienes. Máxima calidad, mayor coste, mayor latencia. claude-opus-5-5 o el equivalente.
Tier 2 — Modelo rápido: Un modelo más pequeño y más barato del mismo proveedor o de uno alternativo. claude-haiku-4-5 o gpt-4o-mini. Responde en ~400ms y normalmente está disponible aunque el modelo principal esté saturado.
Tier 3 — Caché semántica: Respuestas anteriores de alta calidad buscadas por similitud vectorial. Si alguien hace una pregunta muy parecida a una que el agente ya respondió bien, sirves esa respuesta sin llamar a ningún LLM.
Tier 4 — Lógica determinista: Reglas, regex, plantillas, consultas a base de datos. Para los casos que tienen una respuesta clara y estable, el LLM es un overhead innecesario. Un agente de facturación puede extraer un número de pedido con una regex; un agente de FAQ puede buscar por keyword.
Tier 5 — Error con contexto: Nunca un 500 genérico. Un mensaje que explica qué pasó, qué puede hacer el usuario y cuándo esperar que se resuelva.
Implementación real con los cuatro tiers
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic();

// Tier 1: Modelo primario
async function callPrimaryModel(input: AgentInput): Promise<AgentOutput> {
  const response = await client.messages.create({
    model: "claude-opus-5-5",
    max_tokens: 1024,
    messages: [{ role: "user", content: input.query }],
    system: input.systemPrompt,
  });
  return parseResponse(response);
}

// Tier 2: Modelo rápido del mismo proveedor
async function callFastModel(input: AgentInput): Promise<AgentOutput> {
  const response = await client.messages.create({
    model: "claude-haiku-4-5-20251001",
    max_tokens: 512,
    messages: [{ role: "user", content: input.query }],
    system: input.systemPrompt,
  });
  return parseResponse(response);
}

// Tier 3: Búsqueda semántica en caché
async function searchSemanticCache(
  input: AgentInput
): Promise<AgentOutput | null> {
  const embedding = await getEmbedding(input.query);
  const similar = await vectorDB.search({
    vector: embedding,
    threshold: 0.92, // Solo si es muy similar
    limit: 1,
  });

  if (!similar.length) return null;
  return { ...similar[0].cachedResponse, cached: true };
}

// Tier 4: Extracción determinista
function deterministicFallback(input: AgentInput): AgentOutput | null {
  // Ejemplo: agente de soporte con FAQs indexadas
  const keyword = extractMainKeyword(input.query);
  const faqMatch = faqIndex.findByKeyword(keyword);
  if (faqMatch) return { answer: faqMatch.answer, source: "faq" };

  return null;
}

// Cadena completa
async function agentWithFallback(input: AgentInput) {
  // Tier 1
  if (circuitBreaker.isHealthy("claude-opus")) {
    try {
      return await withTimeout(callPrimaryModel(input), 8000);
    } catch {
      circuitBreaker.recordFailure("claude-opus");
    }
  }

  // Tier 2
  if (circuitBreaker.isHealthy("claude-haiku")) {
    try {
      return await withTimeout(callFastModel(input), 3000);
    } catch {
      circuitBreaker.recordFailure("claude-haiku");
    }
  }

  // Tier 3
  const cached = await searchSemanticCache(input).catch(() => null);
  if (cached) return cached;

  // Tier 4
  const deterministic = deterministicFallback(input);
  if (deterministic) return deterministic;

  // Tier 5: siempre responde
  return {
    answer: degradedMessage(input.context),
    degraded: true,
    retryAfter: 60,
  };
}
La función degradedMessage importa más de lo que parece
El mensaje de error no es un detalle de UX. Es la última comunicación de tu sistema con el usuario en un momento de fallo. Lo que escribes ahí afecta directamente la percepción de fiabilidad del producto.
function degradedMessage(context: AgentContext): string {
  const messages: Record<AgentContext, string> = {
    "invoice-extraction":
      "El procesamiento automático no está disponible en este momento. " +
      "Puedes subir el archivo manualmente en el panel de facturas. " +
      "El sistema se recuperará en los próximos minutos.",
    "customer-support":
      "Nuestro asistente está temporalmente no disponible. " +
      "Tu consulta ha quedado registrada y recibirás respuesta en menos de 2 horas.",
    "data-analysis":
      "El análisis automático está pausado por mantenimiento. " +
      "Los datos están guardados y se procesarán automáticamente en cuanto el sistema se recupere.",
  };

  return messages[context] ?? "Servicio temporalmente no disponible. Inténtalo de nuevo en unos minutos.";
}
Cuándo cada tier salva el SLA
El circuit breaker y los reintentos resuelven los fallos transitorios (un 429 momentáneo, un timeout de red). La cadena de fallback resuelve los fallos sostenidos.
En la práctica, estos son los escenarios donde cada tier interviene:
Tier 2 actúa cuando el modelo primario está saturado (529 overloaded) o cuando la latencia supera el timeout definido. Ocurre varias veces al mes en cualquier sistema de producción. El usuario no nota nada salvo, quizás, una respuesta ligeramente más corta.
Tier 3 actúa durante incidentes del proveedor (caídas de 30-60 minutos) y en casos de alta demanda simultánea. Las respuestas cacheadas con alta similitud semántica son indistinguibles para el usuario de las generadas en tiempo real.
Tier 4 actúa en incidentes largos o cuando los tiers de LLM están ambos caídos. Cubre el porcentaje de consultas que tienen una respuesta estructurada conocida — en muchos dominios, entre el 20% y el 40% del tráfico.
Tier 5 actúa solo cuando todo lo demás ha fallado. En sistemas bien diseñados, cubre menos del 1% del tráfico.
El error que hace fallar la cadena
El fallo más común en la implementación de fallback chains no es técnico. Es de diseño: los tiers no están aislados correctamente.
Si el Tier 3 (caché semántica) llama a la misma API de embeddings que el Tier 1 usa internamente, y esa API está caída, tu "fallback" depende del sistema que acabas de declarar caído. Mismo problema si tu lógica determinista (Tier 4) hace una consulta a base de datos con las mismas credenciales que el agente principal.
Cada tier debe tener sus propias dependencias. La caché semántica puede usar un índice local en memoria para los hits más frecuentes. Las reglas deterministas deben poder ejecutarse con datos en memoria o en una base de datos separada.
Si los sistemas de integración de IA que construyes comparten infraestructura entre tiers, la cadena colapsará exactamente en el momento que más la necesitas: cuando tu infraestructura principal está bajo presión.
Observabilidad: qué tier respondió y por qué
Una cadena de fallback sin métricas es un sistema opaco. Necesitas saber, para cada respuesta:
- Qué tier respondió
- Por qué los tiers anteriores fallaron
- Cuánto tiempo lleva cada tier activo en "modo degradado"
// Añade el tier de respuesta a cada request
const result = await agentWithFallback(input);

await metrics.record({
  tier: result.tier,
  latency: Date.now() - startTime,
  cached: result.cached ?? false,
  degraded: result.degraded ?? false,
  context: input.context,
});

if (result.degraded) {
  await alerts.notify({
    level: "warn",
    message: `Agent serving degraded responses for context: ${input.context}`,
    duration: degradedSince,
  });
}
Una alerta que dispara cuando el Tier 2 lleva más de 5 minutos respondiendo —en lugar de el Tier 1— te da tiempo de actuar antes de que el usuario lo note.
Resultados reales
En los proyectos de integración de agentes IA donde hemos implementado cadenas de fallback de cuatro tiers, los incidentes de proveedor que antes causaban un 100% de errores durante su duración han pasado a causar un 0-2% de respuestas degradadas visibles para el usuario.
El cambio no viene de que los proveedores fallen menos. Viene de que el sistema sabe qué hacer cuando fallan.
Si estás construyendo un agente IA para producción y todavía no tienes definida tu cadena de fallback, el siguiente incidente del proveedor lo descubrirás por los reportes de error de tus usuarios.