Event Sourcing en Agentes IA: Estado que No Miente
Tu agente procesa una factura: busca al cliente, valida importes, llama a tres herramientas externas, construye el payload y está a punto de enviar cuando cae por timeout a los 30 segundos.
¿Qué haces ahora? ¿Reinicias desde cero y rezas para que las llamadas idempotentes no dupliquen nada? ¿Lees la BD para inferir qué hizo y qué no? ¿Simplemente no sabes?
Ese "no sé exactamente en qué punto quedó" es el problema que event sourcing resuelve. Y es un problema que aparece exactamente cuando los flujos de agente se vuelven lo suficientemente complejos como para que importen.
Por qué el estado de un agente es mentiroso por defecto
Cuando un agente actualiza su estado a través de tool calls y llama a APIs externas, el estado que ves en la BD en un momento dado es una foto, no una historia. Sabes dónde está el proceso ahora, pero no cómo llegó hasta ahí.
Esto genera tres problemas reales en producción:
No puedes reanudar con precisión. Si el agente cayó después de fetch_client pero antes de create_invoice, tu BD puede mostrar status: "processing" sin más contexto. Reiniciar desde cero arriesga duplicar la llamada a fetch_client; saltar directamente a create_invoice arriesga trabajar con datos que no recuperaste.
El debugging es arqueología. Cuando un flujo produce un resultado incorrecto tres horas después de ejecutarse, ¿qué herramientas llamó el agente? ¿En qué orden? ¿Qué respuesta obtuvo de cada una? Sin un log estructurado de acciones, estás mirando el estado final e intentando reconstruir hacia atrás.
La auditoría no existe. Para procesos regulados —facturación, contratos, datos de cliente— necesitas poder demostrar qué hizo el agente, cuándo y con qué datos. Un campo updated_at en la BD no es auditoría.
Qué es event sourcing aplicado a agentes IA
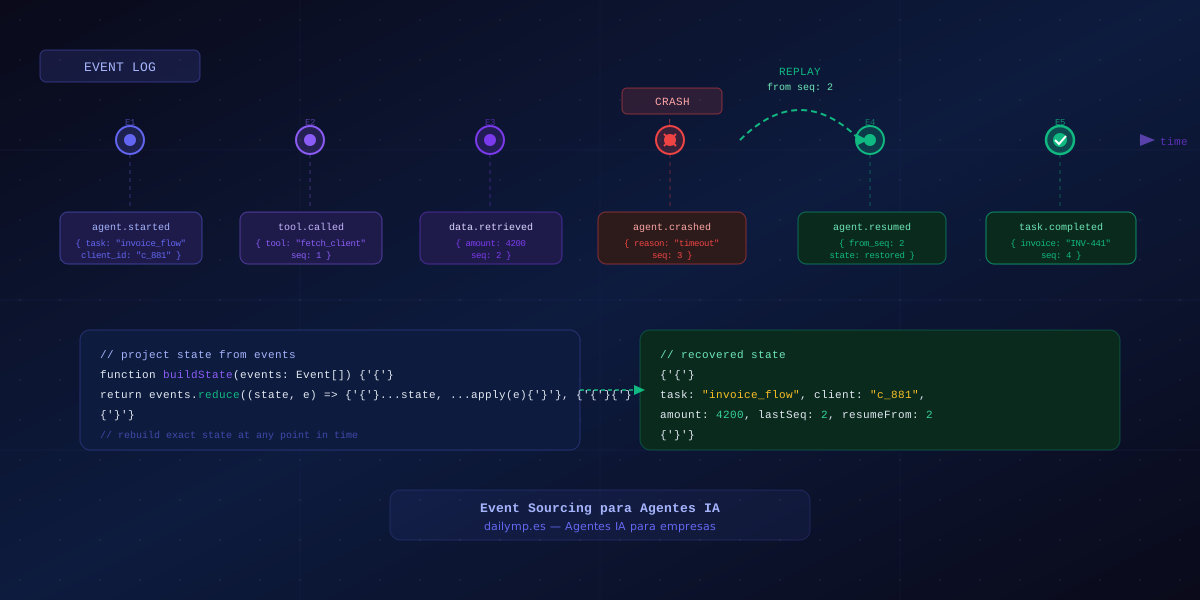
La idea es simple: en lugar de guardar el estado actual del agente, guardas cada acción como un evento inmutable. El estado actual es siempre una proyección derivada de esos eventos.
type AgentEvent =
  | { type: "agent.started"; taskId: string; input: unknown; seq: number; ts: number }
  | { type: "tool.called"; tool: string; args: unknown; seq: number; ts: number }
  | { type: "tool.result"; tool: string; result: unknown; seq: number; ts: number }
  | { type: "agent.crashed"; reason: string; seq: number; ts: number }
  | { type: "task.completed"; output: unknown; seq: number; ts: number };

interface EventStore {
  append(taskId: string, event: Omit<AgentEvent, "seq">): Promise<AgentEvent>;
  list(taskId: string, fromSeq?: number): Promise<AgentEvent[]>;
}
El campo seq es el número de secuencia. Es lo que hace posible el replay: puedes pedir todos los eventos desde el seq 2 y reconstruir exactamente el estado que tenía el agente en ese punto.
Cómo se construye el event store en TypeScript
Una implementación mínima sobre PostgreSQL (o tu BD actual) tiene tres piezas:
// La tabla en BD
// CREATE TABLE agent_events (
//   id         SERIAL PRIMARY KEY,
//   task_id    TEXT NOT NULL,
//   seq        INT NOT NULL,
//   type       TEXT NOT NULL,
//   payload    JSONB NOT NULL,
//   ts         BIGINT NOT NULL,
//   UNIQUE (task_id, seq)
// );

async function appendEvent(
  db: Pool,
  taskId: string,
  type: string,
  payload: unknown,
  seq: number
): Promise<void> {
  await db.query(
    `INSERT INTO agent_events (task_id, seq, type, payload, ts)
     VALUES ($1, $2, $3, $4, $5)
     ON CONFLICT (task_id, seq) DO NOTHING`,
    [taskId, seq, type, JSON.stringify(payload), Date.now()]
  );
}

async function getEvents(
  db: Pool,
  taskId: string,
  fromSeq = 0
): Promise<AgentEvent[]> {
  const rows = await db.query(
    `SELECT seq, type, payload, ts FROM agent_events
     WHERE task_id = $1 AND seq >= $2 ORDER BY seq ASC`,
    [taskId, fromSeq]
  );
  return rows.rows.map(r => ({ ...r.payload, type: r.type, seq: r.seq, ts: r.ts }));
}
El ON CONFLICT DO NOTHING en el insert es la clave de la idempotencia: si el agente se reinicia y intenta escribir el mismo evento otra vez, simplemente no hace nada.
Proyectar estado desde eventos
Una vez tienes el log de eventos, derivar el estado actual es una reducción pura:
interface TaskState {
  taskId: string;
  status: "running" | "crashed" | "completed";
  lastSeq: number;
  toolResults: Record<string, unknown>;
  output?: unknown;
}

function projectState(events: AgentEvent[]): TaskState {
  return events.reduce<TaskState>(
    (state, event) => {
      switch (event.type) {
        case "agent.started":
          return { ...state, status: "running", lastSeq: event.seq };
        case "tool.result":
          return {
            ...state,
            lastSeq: event.seq,
            toolResults: { ...state.toolResults, [event.tool]: event.result },
          };
        case "agent.crashed":
          return { ...state, status: "crashed", lastSeq: event.seq };
        case "task.completed":
          return { ...state, status: "completed", lastSeq: event.seq, output: event.output };
        default:
          return { ...state, lastSeq: event.seq };
      }
    },
    { taskId: "", status: "running", lastSeq: 0, toolResults: {} }
  );
}
Cuando el agente se reinicia después de un crash, llama a getEvents(taskId), proyecta el estado, y sabe exactamente qué herramientas ya llamó y qué resultados obtuvo. No repite nada que ya completó.
El patrón que conecta con tu agente real
Dentro del bucle principal del agente, cada tool call se convierte en dos eventos:
async function callToolWithEvents(
  store: EventStore,
  taskId: string,
  tool: string,
  args: unknown,
  seq: number
): Promise<unknown> {
  // Si ya existe en el estado proyectado, no llamamos a la tool: devolvemos el resultado cacheado
  const events = await store.list(taskId);
  const state = projectState(events);
  if (state.toolResults[tool]) return state.toolResults[tool];

  await store.append(taskId, { type: "tool.called", tool, args, seq, ts: Date.now() });
  const result = await callTool(tool, args); // tu implementación real
  await store.append(taskId, { type: "tool.result", tool, result, seq: seq + 1, ts: Date.now() });
  return result;
}
Con este patrón, si el agente cae entre tool.called y tool.result —justo en la llamada externa— al reiniciarse no tiene el resultado cacheado y repite la llamada. Si cae después de tool.result, sí tiene el resultado y lo salta. En ambos casos, el comportamiento es predecible.
Cuándo usar event sourcing y cuándo no
Event sourcing tiene un coste real: más escrituras en BD, más lógica en el agente, estado que vive en dos sitios (evento + proyección). No es para todos los flujos.
Tiene sentido cuando:
- El flujo es largo (más de 3-4 tool calls secuenciales)
- Alguna de las tool calls tiene efectos externos difíciles de revertir (enviar un email, crear un registro en un CRM, llamar a una API de pago)
- Necesitas auditoría por contrato o regulación
- El coste de re-ejecutar desde cero es alto (tiempo, dinero, riesgo de duplicados)
No lo necesitas cuando el flujo es corto, todas las operaciones son idempotentes por diseño, o el agente puede simplemente reintentar sin consecuencias.
La diferencia con observabilidad y con saga
Event sourcing no es lo mismo que tracing con OpenTelemetry. El tracing registra qué pasó para que lo leas tú. Event sourcing registra qué pasó para que el agente mismo lo pueda leer y continuar.
Tampoco es el patrón Saga, que gestiona compensaciones cuando algo falla —deshacer lo que se hizo. Event sourcing es neutral respecto a la compensación: simplemente garantiza que tienes el historial completo para tomar cualquier decisión, incluida la de compensar.
Son patrones complementarios. Un agente robusto en producción suele usar los dos: event sourcing para el estado, saga para la lógica de compensación cuando es necesaria. En DAILYMP es la arquitectura que aplicamos en flujos de agente que tocan sistemas externos críticos.
El síntoma que deberías monitorizar
Si en los logs de tu agente ves variantes de "no sé en qué punto quedó el proceso anterior, reinicio desde cero", tienes el problema que event sourcing resuelve. No siempre es evidente porque el reinicio silencioso desde cero puede funcionar la mayoría de las veces —hasta que no funciona.
El coste de detectarlo tarde es alto: datos duplicados en CRMs, facturas enviadas dos veces, estado inconsistente que el soporte tarda horas en diagnosticar.
Si estás construyendo agentes que tocan procesos críticos de negocio —facturación, contratos, atención al cliente, pipelines de datos— la pregunta no es si necesitas event sourcing. Es cuándo te va a doler no tenerlo.
¿Quieres ver cómo se aplica esto en un flujo real de tu empresa? En la integración de IA para empresas construimos la capa de resiliencia desde el principio, no como parche posterior.