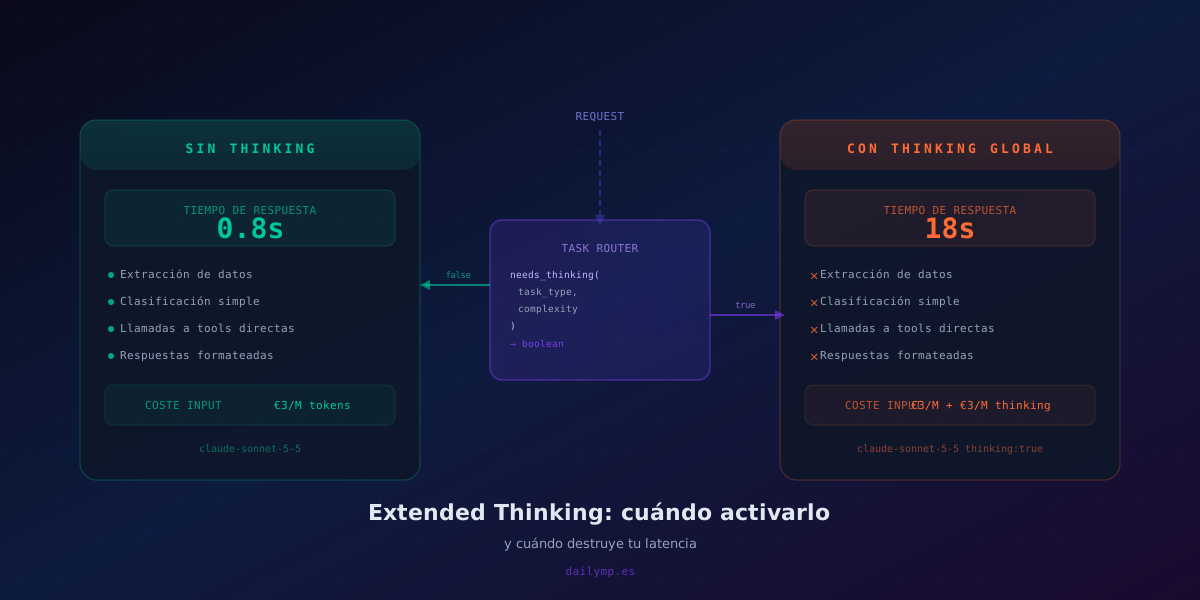
Extended thinking: cuándo activarlo (y cuándo no)
Tu agente IA tarda 18 segundos en contestar. El modelo es bueno, el servidor está bien. El problema es que activaste extended thinking en todas las llamadas pensando que más razonamiento siempre es mejor.
No lo es. Y ese error le cuesta a muchos equipos latencia, dinero y users que abandonan antes de ver la respuesta.
Qué es extended thinking y qué hace realmente
Extended thinking es un modo de los modelos Claude más recientes en el que el modelo genera un bloque interno de razonamiento (<thinking>) antes de producir la respuesta final. No lo ves en el output, pero el modelo trabaja más tiempo y usa más tokens.
El resultado es mejor en tareas que requieren razonamiento complejo: matemáticas, código con múltiples restricciones, análisis de situaciones ambiguas con trade-offs. En esas tareas sube la calidad de forma medible.
El problema es lo que no mejora: una extracción de campos de un formulario, una clasificación de intención de usuario, una llamada a una herramienta con parámetros obvios. Para esas tareas el thinking no cambia el output — solo añade entre 3 y 30 segundos y multiplica el coste.
Si has activado thinking: { type: "enabled", budget_tokens: 8000 } en tu cliente de forma global, estás pagando ese coste en cada petición, la mayoría de las cuales no lo necesitan.
Por qué el thinking global es el error más caro
Cuando hablo con CTOs que tienen un agente IA en producción y que se quejan del coste o la latencia, una de las primeras preguntas que hago es si tienen thinking activado. La respuesta suele ser "sí, lo pusimos para tener los mejores resultados".
El razonamiento es correcto en teoría. El problema es que no discrimina.
Un agente típico hace docenas de tipos de llamadas distintas:
- Clasificar si la intención del usuario es "soporte" o "ventas"
- Extraer nombre, email y empresa de un texto libre
- Decidir qué herramienta llamar dado un contexto claro
- Escribir una respuesta estructurada siguiendo un template
- Razonar sobre un contrato complejo con cláusulas contradictorias
- Planificar los pasos de un proceso largo con dependencias
Solo el último caso justifica extended thinking. El resto añade latencia y coste sin ningún beneficio.
El patrón correcto: routing por complejidad de tarea
La solución no es desactivar thinking — es activarlo selectivamente. Necesitas una capa de decisión que evalúe cada llamada antes de ejecutarla.
// lib/thinking-router.ts

type TaskType =
  | "extraction"
  | "classification"
  | "tool-call"
  | "generation"
  | "reasoning"
  | "planning";

interface TaskConfig {
  type: TaskType;
  inputLength?: number;
  hasConstraints?: boolean;
  requiresMultiStep?: boolean;
}

function needsThinking(task: TaskConfig): boolean {
  // Nunca para extracción simple o clasificación
  if (task.type === "extraction" || task.type === "classification") {
    return false;
  }

  // Nunca para tool calls directas
  if (task.type === "tool-call") {
    return false;
  }

  // Para generación: solo si tiene restricciones complejas
  if (task.type === "generation") {
    return (task.hasConstraints ?? false) && (task.inputLength ?? 0) > 2000;
  }

  // Reasoning y planning: casi siempre justifican thinking
  return task.type === "reasoning" || task.type === "planning";
}

// Uso en tu agente
async function callModel(prompt: string, task: TaskConfig) {
  const useThinking = needsThinking(task);

  const response = await anthropic.messages.create({
    model: "claude-sonnet-5-5",
    max_tokens: useThinking ? 16000 : 4096,
    ...(useThinking && {
      thinking: {
        type: "enabled",
        budget_tokens: 8000,
      },
    }),
    messages: [{ role: "user", content: prompt }],
  });

  return response;
}
Con este patrón, el 80-90% de tus llamadas siguen siendo rápidas (bajo 1 segundo). Solo las que realmente requieren razonamiento complejo activan el thinking.
Cuánto cuesta activar thinking en todo
Los números concretos con Claude Sonnet 5.5 a precios actuales:
| Llamada | Sin thinking | Con thinking (8k budget) |
|---|---|---|
| Clasificación 200 tokens | ~€0,0006 · 0,8s | ~€0,006 · 6s |
| Extracción 500 tokens | ~€0,0015 · 1,0s | ~€0,015 · 8s |
| Planificación compleja | ~€0,009 · 2s | ~€0,030 · 18s |
Para las dos primeras tareas, el thinking es 10 veces más caro y entre 6 y 8 veces más lento. Para la planificación compleja, el coste extra puede estar justificado si mejora la calidad del plan.
Si tu agente hace 1.000 llamadas al día y el 70% son clasificación y extracción, activar thinking en todo puede suponer entre €3 y €8 de coste extra diario solo por esas llamadas — sin ninguna mejora en el resultado.
Cómo medir el impacto antes de decidir
No tomes la decisión a ojo. Antes de implementar el router, instrumenta tus llamadas actuales para entender cuántas serían candidatas a thinking:
// middleware/thinking-logger.ts
export function withThinkingAudit<T>(
  taskType: TaskType,
  fn: () => Promise<T>
): Promise<T> {
  const start = Date.now();

  return fn().then((result) => {
    const duration = Date.now() - start;

    console.log(
      JSON.stringify({
        task_type: taskType,
        duration_ms: duration,
        thinking_recommended: needsThinking({ type: taskType }),
        timestamp: new Date().toISOString(),
      })
    );

    return result;
  });
}
Con una semana de datos tendrás la distribución real de tipos de tarea en tu agente. Eso te permite calcular el ahorro exacto antes de tocar el código de producción.
Cuándo extended thinking sí vale la pena
Para ser claros: no estoy diciendo que extended thinking sea malo. Es una herramienta potente para los casos correctos.
Los escenarios donde justifica el coste de latencia:
- Análisis de contratos o documentos legales con cláusulas que se contradicen entre sí
- Planificación de proyectos donde hay dependencias entre tareas y restricciones de recursos
- Generación de código complejo con múltiples requisitos que deben cumplirse simultáneamente
- Diagnóstico de problemas donde el agente necesita razonar sobre causas posibles antes de actuar
En todos estos casos, el razonamiento adicional produce outputs cualitativamente mejores. El usuario está dispuesto a esperar 15-20 segundos porque el resultado vale la diferencia.
Lo que esto tiene que ver con el coste de tu proyecto
Este es exactamente el tipo de decisión de arquitectura que marca la diferencia entre un agente que escala bien y uno que se vuelve inmanejable a medida que crece el uso.
No es un problema visible al principio. Con 50 llamadas al día, la diferencia entre thinking global y thinking selectivo es de céntimos. Con 5.000 llamadas al día, es la diferencia entre un coste operativo asumible y una factura que come el margen del producto.
En los proyectos de integración de IA que hacemos en DAILYMP, revisamos este tipo de decisiones desde el diseño inicial. Es mucho más barato hacerlo bien desde el principio que refactorizar la arquitectura cuando la factura ya duele.
Si tienes un agente en producción y no estás seguro de cómo está configurado el thinking — o si todavía no lo tienes pero estás planificando incorporarlo — podemos revisar juntos la arquitectura y darte un diagnóstico concreto.
Escríbeme por WhatsApp y lo vemos.