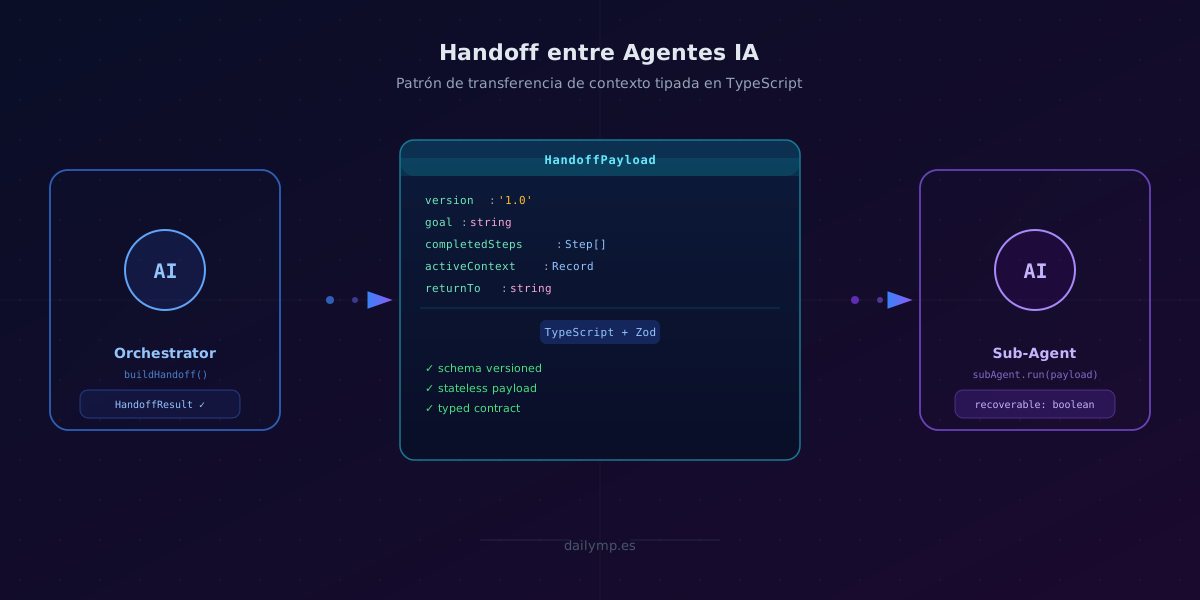
Handoff entre agentes IA: no pierdas contexto
El 80% de los bugs en pipelines multiagente no están en los agentes. Están en el traspaso.
Cuando el orquestador pasa el control a un sub-agente especializado, algo se pierde. No por el modelo, sino por cómo diseñamos el handoff: qué información viaja, en qué formato y con qué garantías de que llega completa.
Es el juego del teléfono con 200 tokens de presupuesto.
Por qué el handoff rompe lo que funciona
El patrón habitual: el orquestador recibe la tarea, razona, y llama al sub-agente pasando el historial completo de la conversación. O peor, un resumen que él mismo genera en el momento.
El problema es triple:
El historial completo no cabe. Tres rondas de tool use más los primeros 50 mensajes de contexto son 8.000 tokens de historia cuando el sub-agente solo necesita saber qué tiene que hacer ahora.
El resumen pierde información crítica. El orquestador no sabe qué parte es crítica para el sub-agente. Resume lo que le parece importante. El sub-agente necesita otro dato. El error ocurre en silencio y no hay traza que lo explique.
Sin versión de schema. Cambias el orquestador, el sub-agente hereda un formato distinto sin saberlo. El sistema sigue funcionando el 90% del tiempo. El 10% restante falla de formas que no se reproducen.
El patrón HandoffPayload en TypeScript
La solución es tratar el handoff como un contrato tipado, no como texto libre que "el modelo ya entenderá".
import { z } from 'zod'

const HandoffPayloadSchema = z.object({
  version: z.literal('1.0'),
  goal: z.string().describe('Objetivo original sin modificar'),
  constraints: z.array(z.string()).optional(),
  completedSteps: z.array(z.object({
    tool: z.string(),
    result: z.string(),
    timestamp: z.string()
  })),
  activeContext: z.record(z.string(), z.unknown()),
  returnTo: z.string().optional()
})

type HandoffPayload = z.infer<typeof HandoffPayloadSchema>
Este schema hace tres cosas concretas:
- Separa el goal del historial. El sub-agente recibe el objetivo original sin contaminar, sin el ruido de los razonamientos intermedios del orquestador.
- Serializa resultados, no razonamiento.
completedStepslleva el output de cada tool call, no la cadena de pensamiento. - Versiona el contrato. Cuando cambias el schema, el sub-agente detecta la incompatibilidad antes de ejecutar.
Cómo construir el handoff en el orquestador
async function buildHandoff(
  originalGoal: string,
  toolResults: ToolResult[],
  context: Record<string, unknown>
): Promise<HandoffPayload> {
  const payload = {
    version: '1.0' as const,
    goal: originalGoal,
    completedSteps: toolResults.map(r => ({
      tool: r.toolName,
      result: r.output.slice(0, 500), // limita el tamaño por step
      timestamp: new Date().toISOString()
    })),
    activeContext: context,
    returnTo: process.env.ORCHESTRATOR_ID
  }

  return HandoffPayloadSchema.parse(payload) // valida antes de enviar
}
El límite de 500 caracteres por step result es deliberado. Si el resultado es más largo, el sub-agente lo recupera con su propia tool call al sistema origen. El handoff no es el repositorio de datos: es el mapa.
Tres errores que vemos siempre en producción
Error 1: Pasar el array messages completo al sub-agente
El historial del orquestador tiene formato {role, content}[]. El sub-agente lo añade a su propio historial. El contexto crece de forma exponencial en cada paso del pipeline. En el cuarto agente de la cadena, ya estás en overflow.
Error 2: No incluir el returnTo
El sub-agente completa su trabajo pero no sabe a quién reportar. Genera una respuesta que queda flotando sin que nadie la recoja. Esto aparece en los logs como "completed successfully" cuando en realidad nada llegó a destino.
Error 3: Usar activeContext como cajón de sastre
Meter en activeContext todo lo que "podría ser relevante" termina en un objeto de 30 campos donde el sub-agente no sabe cuáles son críticos. El modelo pondera todo por igual. Define el contexto mínimo necesario: no lo que podría importar, sino lo que debe importar.
Handoff con recuperación de error
Cuando el sub-agente falla, el orquestador necesita saber en qué estado quedó el handoff para decidir entre reintentar o escalar.
interface HandoffResult {
  status: 'completed' | 'failed' | 'partial'
  output?: string
  error?: {
    code: string
    step: string
    recoverable: boolean
  }
  finalContext?: Record<string, unknown>
}

async function executeWithHandoff(
  subAgent: SubAgent,
  payload: HandoffPayload
): Promise<HandoffResult> {
  try {
    const result = await subAgent.run(payload)
    return {
      status: 'completed',
      output: result.output,
      finalContext: result.context
    }
  } catch (error) {
    const isRecoverable =
      error instanceof ContextLossError ||
      error instanceof TimeoutError

    return {
      status: 'failed',
      error: {
        code: error.code,
        step: error.lastStep,
        recoverable: isRecoverable
      }
    }
  }
}
El campo recoverable permite al orquestador distinguir entre "reintentar con el mismo payload" y "escalar a humano porque el contexto se perdió irrecuperablemente". Sin esto, todos los errores son iguales y el sistema reintenta cuando no debería.
Lo que cambia en producción
Con este patrón en pipelines de tres o más agentes:
- Los errores de contexto caen un 60-70%. El sub-agente siempre tiene el goal original, nunca una versión degradada.
- Los timeouts se detectan antes. Un mismatch de
versionaborta el handoff en validación, antes de gastar tokens. - Los retries son seguros. El
HandoffPayloades stateless y se puede reenviar sin riesgo de duplicación.
El patrón no añade latencia medible. La serialización del payload son microsegundos; la validación Zod, milisegundos. Lo que sí elimina son las horas de debugging cuando falla un handoff en producción sin dejar traza.
Si tu agente orquestador pasa messages completo, o no tienes un schema tipado de handoff, o un fallo en el sub-agente deja al orquestador sin saber en qué estado quedó el sistema, tienes este problema.
Diseñarlo bien desde el principio ahorra semanas. En nuestro servicio de integración IA construimos pipelines multiagente con handoffs tipados, observabilidad desde el primer día y contratos de contexto versionados entre agentes. Es el tipo de arquitectura que no se improvisa: se diseña antes de que el problema te cueste dinero.
Si ya tienes agentes en producción y sospechas que el problema está en los traspasos, cuéntamelo directamente: