Tool result cache en agentes IA: elimina llamadas duplicadas
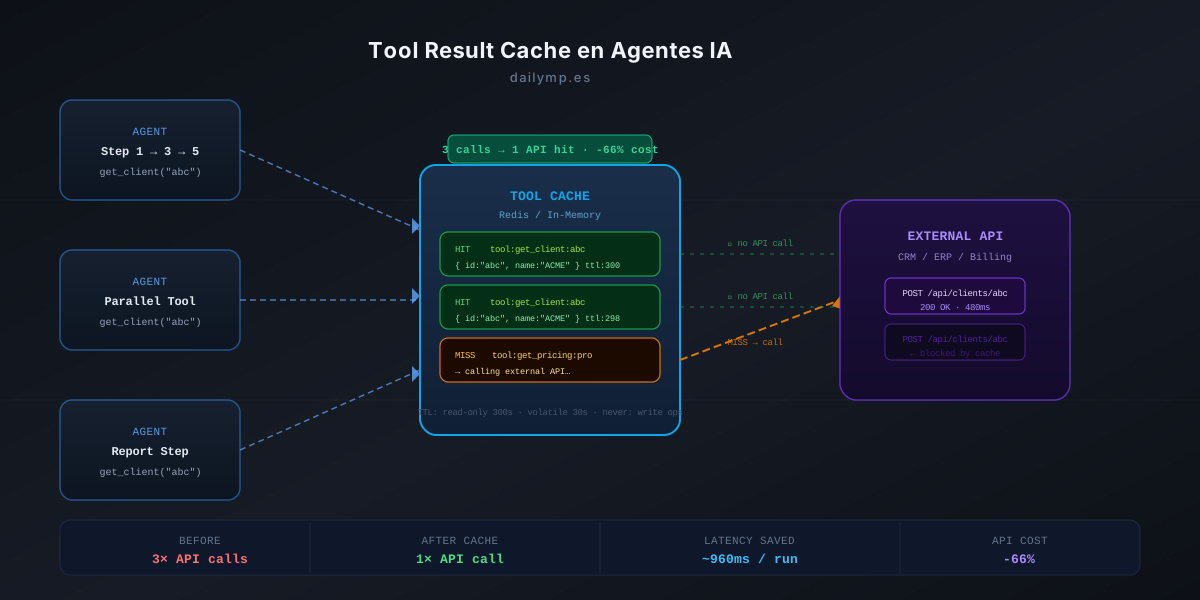
Tu agente de facturación tiene cinco pasos. En el paso 2 llama a get_client_data("abc-123") para construir el cuerpo de la factura. En el paso 3 vuelve a llamarla para rellenar el asunto del email. En el paso 5 la llama de nuevo para incluir los datos en el informe final.
Tres llamadas idénticas. Tres veces 480ms de latencia. Tres veces el coste de la API externa.
Y el LLM no tiene la culpa: no "recuerda" que ya ejecutó esa herramienta con esos argumentos. Cada paso del workflow es un nuevo contexto.
Por qué el semantic cache no resuelve esto
Antes de construir nada, es importante separar dos problemas que se confunden habitualmente:
Semantic cache (ya cubierto en el artículo sobre caché semántica) almacena respuestas del LLM cuando el usuario hace preguntas similares. "¿Cuánto cuesta?" y "¿Qué precio tiene?" devuelven la misma respuesta cacheada. El ahorro es en llamadas al modelo.
Tool result cache opera en una capa completamente distinta: almacena el resultado de una herramienta externa cuando se llama con los mismos argumentos, dentro del mismo agente. El ahorro es en llamadas a APIs externas — CRM, ERP, servicios de terceros, bases de datos.
Son complementarias. Si tienes las dos, reduces coste en dos frentes. Si solo tienes una, sigues pagando de más en la otra.
El patrón: wrapper transparente sobre cualquier tool
La implementación más limpia es un wrapper que intercepta la ejecución de la herramienta antes de que llegue a la API:
import { createHash } from 'crypto';
import { Redis } from '@upstash/redis';

class CachedTool {
  constructor(
    private tool: { name: string; execute: (args: unknown) => Promise<unknown> },
    private redis: Redis,
    private ttl: number
  ) {}

  async execute(args: unknown): Promise<unknown> {
    const key = this.buildKey(args);
    const cached = await this.redis.get<string>(key);
    if (cached) return JSON.parse(cached);

    const result = await this.tool.execute(args);
    await this.redis.setex(key, this.ttl, JSON.stringify(result));
    return result;
  }

  private buildKey(args: unknown): string {
    const hash = createHash('sha256')
      .update(`${this.tool.name}:${JSON.stringify(args)}`)
      .digest('hex');
    return `toolcache:${hash}`;
  }
}
El agente llama a cachedTool.execute(args) exactamente igual que antes. Si hay hit, devuelve el dato en memoria en menos de 10ms en lugar de esperar 400-600ms a la API externa. Si hay miss, ejecuta la tool, almacena el resultado y lo devuelve.
Qué tools cachear y cuáles no
Esta es la decisión más importante del diseño. La regla es simple: solo cachear tools idempotentes.
Cachear (operaciones de lectura):
get_client,get_invoice,get_product_catalogquery_database,read_document,fetch_config- Cualquier llamada cuyo resultado no cambia si se ejecuta N veces
Nunca cachear (operaciones de escritura):
send_email,send_whatsapp,create_recordupdate_status,delete_item,charge_payment- Cualquier operación con efectos secundarios
Si cacheas un send_email, el primer envío funciona. Los siguientes devuelven el resultado del primero desde caché — y el email no se manda. Eso es exactamente lo que no quieres.
Una forma de forzar esta distinción en TypeScript es tipar los tools según su naturaleza:
type ReadTool = { readonly idempotent: true; ttl: number };
type WriteTool = { readonly idempotent: false };

function wrapIfCacheable(
  tool: { name: string; execute: Function } & (ReadTool | WriteTool),
  redis: Redis
) {
  if (!tool.idempotent) return tool;
  return new CachedTool(tool, redis, tool.ttl);
}
Tres niveles de TTL según la volatilidad del dato
No todos los datos cambian igual de rápido. Usar el mismo TTL para todo es el segundo error más común después de cachear writes:
| Tipo de dato | TTL recomendado | Ejemplo |
|---|---|---|
| Datos de configuración | 3.600s (1h) | precios, catálogo de productos |
| Datos de cliente | 300s (5 min) | nombre, email, dirección |
| Estado de pedido | 30s | stock actualizado, estado de pago |
| Datos en tiempo real | 0 (no cachear) | cotizaciones de bolsa, inventario crítico |
Si un cliente actualiza su email y el agente usa datos cacheados durante 5 minutos, ese desfase es aceptable. Si el estado de un pago está desactualizado 30 segundos, también. Si cacheas el balance de una cuenta financiera durante una hora, puede ser un problema real.
El TTL es un compromiso explícito entre consistencia y rendimiento. Documenta ese compromiso en el código.
Request-level cache: el caso más sencillo
Para muchos workflows, no hace falta Redis. Un simple Map en memoria local que dure lo que dure el run es suficiente:
class RequestScopedCache {
  private store = new Map<string, unknown>();

  wrap<T>(
    tool: (args: T) => Promise<unknown>,
    name: string
  ) {
    return async (args: T) => {
      const key = `${name}:${JSON.stringify(args)}`;
      if (this.store.has(key)) return this.store.get(key);
      const result = await tool(args);
      this.store.set(key, result);
      return result;
    };
  }
}
Este patrón es particularmente útil en agentes con parallel tool calling: cuando el modelo lanza varias herramientas simultáneamente, dos de ellas pueden llamar a get_client al mismo tiempo. Sin caché, ambas viajan a la API. Con el Map, la primera guarda el resultado y la segunda lo recupera localmente.
El impacto en producción
En un agente de automatización de facturación real, el patrón habitual antes de implementar tool cache:
get_client_data: llamada 3 veces por run → 3 × 480ms = 1.440ms extraget_invoice_settings: llamada 2 veces → 2 × 220ms = 440ms extra- Total overhead evitable: ~1.880ms por run
Con cache activado: 1 llamada real + 4 hits locales. Latencia total de esas 5 operaciones: ~490ms.
En un sistema que procesa 200 facturas al día, eso es 376.000ms de latencia ahorrada — más de seis minutos de espera que desaparecen. Y si cada llamada a la API externa tiene un coste por uso, el ahorro en coste es directamente proporcional al número de hits.
Implementar esto en tu stack
El tool result cache es uno de los patrones que implementamos en todos los proyectos de integración de agentes IA en producción: una capa de infraestructura que no cambia la lógica del agente pero sí su rendimiento y coste real.
Si tienes un agente corriendo en producción y no sabes si está duplicando llamadas, el primer paso es añadir logging de cada tool call con sus argumentos. Dos líneas iguales en el log son la señal.
¿Quieres revisar cuántas llamadas duplicadas tiene tu agente? →