A/B Testing en Agentes IA: Compara Prompts en Producción
Llevas dos semanas refinando el system prompt de tu agente. Cambias el tono, añades ejemplos, reordenas las instrucciones. Lo lanzas a producción. ¿Mejoró? Tu sensación es que sí. Pero eso no es una métrica.
El problema no es que no te importe la calidad — es que no tienes un sistema para medirla en vivo. Los evals corren contra cincuenta casos de prueba. Producción tiene miles de inputs que nunca viste. Y cuando algo falla silenciosamente, te enteras semanas después a través de un usuario frustrado.
El coste real de no saber si mejoraste
Imagina este ciclo: cambias el prompt, despliegas, observas durante dos semanas, "parece que va mejor", sigues adelante. Tres meses después el agente está acumulando cambios de los que no tienes registro y cuya interacción no has medido.
Lo que en realidad ocurre en la mayoría de equipos:
- Un cambio mejora la extracción de fechas y rompe el tono en respuestas negativas
- Actualizar el modelo de
claude-sonnet-4aclaude-sonnet-5reduce latencia pero cambia el comportamiento en edge cases - El prompt que funcionó en dev falla en producción porque los inputs reales tienen ruido que tus tests no tenían
Sin medición sistemática, estás acumulando deuda de calidad invisible.
El patrón shadow deployment para agentes IA
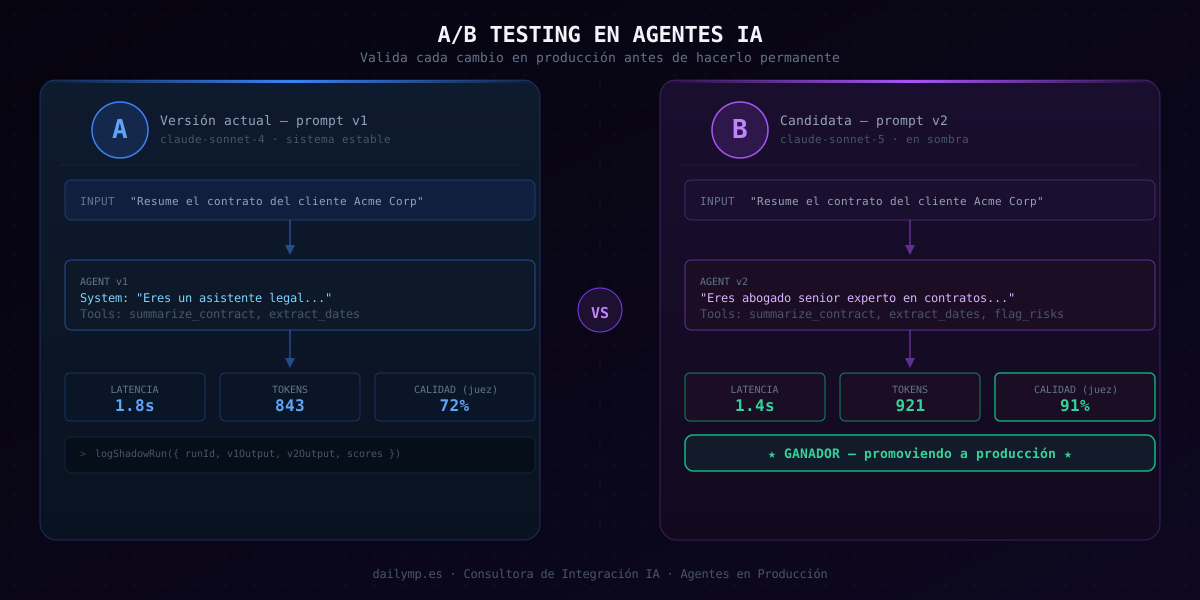
La solución es ejecutar dos versiones en paralelo: la versión activa sirve al usuario, la versión candidata procesa el mismo input en segundo plano. Ambas respuestas se registran. Tú mides cuál gana.
type AgentVersion = 'v1' | 'v2';

interface AgentConfig {
  systemPrompt: string;
  model: string;
  tools: Tool[];
}

const configs: Record<AgentVersion, AgentConfig> = {
  v1: {
    systemPrompt: 'Eres un asistente de contratos...',
    model: 'claude-sonnet-4-6',
    tools: [summarizeContract, extractDates],
  },
  v2: {
    systemPrompt: 'Eres abogado senior especializado en contratos comerciales...',
    model: 'claude-sonnet-5',
    tools: [summarizeContract, extractDates, flagRisks],
  },
};

async function runWithShadow(input: string): Promise<AgentResponse> {
  const [v1Result, v2Result] = await Promise.allSettled([
    runAgent(input, configs.v1),
    runAgent(input, configs.v2),
  ]);

  // Servimos v1 al usuario
  const activeResult = v1Result.status === 'fulfilled' ? v1Result.value : fallback;

  // Registramos ambas para análisis asíncrono
  await logShadowRun({
    runId: crypto.randomUUID(),
    input,
    v1: v1Result.status === 'fulfilled' ? v1Result.value : null,
    v2: v2Result.status === 'fulfilled' ? v2Result.value : null,
    timestamp: new Date().toISOString(),
  });

  return activeResult;
}
Puntos clave de esta implementación
Promise.allSettled en lugar de Promise.all garantiza que si v2 falla, v1 sigue sirviendo al usuario sin interrupción. El shadow nunca puede degradar la experiencia activa.
Los resultados se persisten de forma asíncrona — si la escritura a base de datos es lenta, no bloquea la respuesta al usuario.
Medir cuál versión gana: el scoring automático
Registrar las respuestas es la mitad del trabajo. La otra mitad es puntuar cuál es mejor. Hay tres métricas objetivas que puedes calcular sin intervención humana:
interface ShadowScore {
  latencyMs: number;
  tokenCount: number;
  judgeScore: number; // 0-100, evaluado por otro LLM
}

async function scoreShadowRun(run: ShadowRun): Promise<void> {
  const [v1Score, v2Score] = await Promise.all([
    computeScore(run.v1),
    computeScore(run.v2),
  ]);

  const winner = determineWinner(v1Score, v2Score);

  await db.shadowResults.create({
    data: {
      runId: run.runId,
      v1Score,
      v2Score,
      winner,
    },
  });
}

function determineWinner(
  v1: ShadowScore,
  v2: ShadowScore
): AgentVersion | 'tie' {
  // Pesos configurables según prioridad del negocio
  const v1Total =
    (100 - v1.latencyMs / 50) * 0.2 +
    (100 - v1.tokenCount / 20) * 0.3 +
    v1.judgeScore * 0.5;

  const v2Total =
    (100 - v2.latencyMs / 50) * 0.2 +
    (100 - v2.tokenCount / 20) * 0.3 +
    v2.judgeScore * 0.5;

  if (Math.abs(v1Total - v2Total) < 3) return 'tie';
  return v1Total > v2Total ? 'v1' : 'v2';
}
El judgeScore lo calcula otro LLM con un prompt de evaluación estructurado: ¿la respuesta es correcta, completa y sin alucinaciones? Este LLM-as-judge puede correr en batch con la Batches API de Anthropic para reducir el coste al 50%.
Cuándo promover v2 a producción
La decisión de promover no debe ser manual ni instantánea. Un umbral razonable:
async function shouldPromoteV2(since: Date): Promise<boolean> {
  const results = await db.shadowResults.findMany({
    where: { createdAt: { gte: since } },
  });

  const total = results.length;
  if (total < 200) return false; // muestra estadísticamente insuficiente

  const v2Wins = results.filter(r => r.winner === 'v2').length;
  const winRate = v2Wins / total;

  const v2AvgJudge =
    results.reduce((sum, r) => sum + r.v2Score.judgeScore, 0) / total;

  return winRate > 0.55 && v2AvgJudge > 80;
}
Con 200 runs y una tasa de victorias superior al 55%, tienes suficiente señal para promover con confianza. Menos de eso y el ruido estadístico puede engañarte.
Una vez que decides promover, cambias configs.active = 'v2' y el shadow pasa a comparar v2 vs la siguiente candidata, v3.
Integración con el sistema de observabilidad existente
Este patrón se integra directamente con el tracing que ya tienes si sigues las prácticas de observabilidad para agentes IA. Cada shadowRun lleva el mismo traceId que la petición del usuario, así puedes cruzar el rendimiento del A/B test con los logs de negocio.
El coste adicional es concreto: estás invocando el LLM dos veces por cada petición. Con model routing — v2 usando un modelo más barato durante la fase shadow — el sobrecoste se puede reducir al 20-30%.
Lo que no te dan los evals y sí te da el A/B en producción
Los evals en CI son imprescindibles: te avisan cuando un cambio rompe algo conocido. El A/B en producción hace otra cosa: te dice si el cambio es mejor para los inputs reales que llegan ahora, con su variedad y su ruido.
Son complementarios. El eval te protege contra regresiones. El shadow te da la señal de mejora.
Si estás construyendo un agente para producción y quieres implementar este patrón con la arquitectura específica de tu caso, en DAILYMP trabajamos el ciclo completo: desde el diseño de la estrategia de testing hasta el despliegue y el monitoreo de métricas de calidad en producción.
¿Tienes un agente funcionando y quieres añadir este sistema de validación continua? Escríbeme directamente.