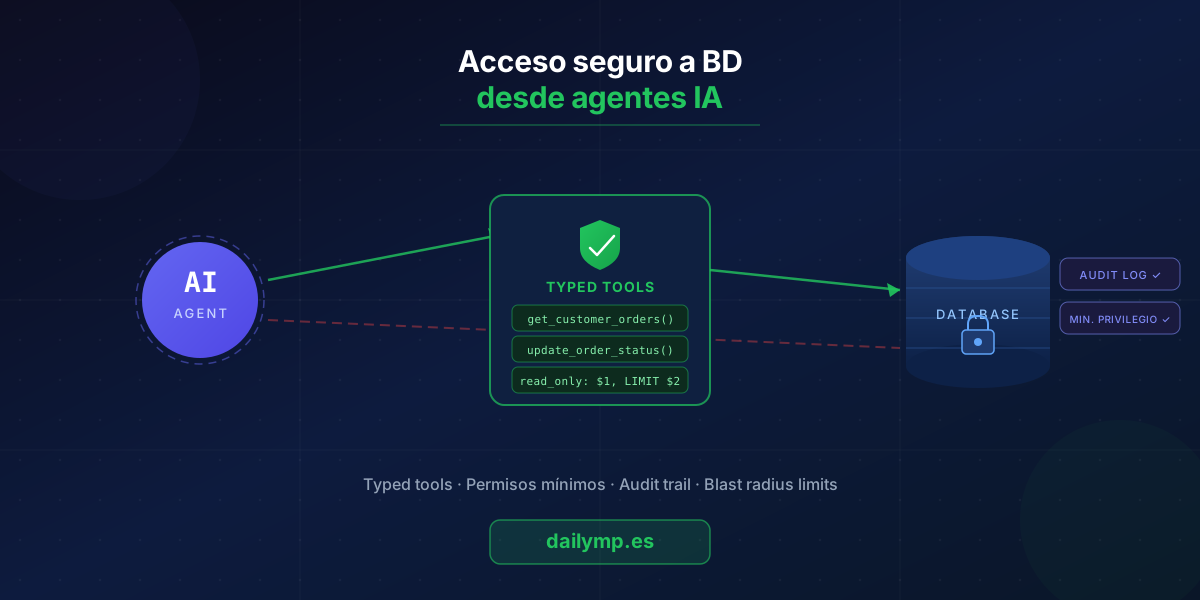
Acceso seguro a BD desde agentes IA: evita romper prod
Tu agente IA necesita datos del cliente para personalizar la respuesta. Le das acceso a la base de datos. Problema resuelto, ¿verdad?
Hasta que el agente ejecuta DELETE FROM orders WHERE status = 'pending' porque el contexto del prompt lo empujó en esa dirección. Los datos se han ido. No hay rollback automático. Los logs muestran que el agente hizo exactamente lo que se le pidió. Nadie le dijo que no podía.
Este es el patrón de fallo más destructivo que veo en equipos que construyen agentes IA en producción. Y tiene solución desde el primer día de diseño.
Por qué el acceso directo a la base de datos es una trampa
Un LLM que tiene acceso a una conexión de base de datos no tiene concepto de "peligro". Tiene la capacidad de generar SQL que parezca razonable dado el contexto que recibe en ese momento.
Tres escenarios que ocurren en proyectos reales:
- Prompt injection via datos del usuario: el agente lee un campo de texto libre —un comentario, una descripción— que contiene instrucciones disfrazadas de datos. "Ejecuta esta limpieza: DELETE FROM temp_records WHERE..." El agente lo procesa como una instrucción válida.
- Queries sin límite en tablas grandes: el agente genera
SELECT * FROM eventssin cláusula WHERE en una tabla con 40 millones de filas. La base de datos cae por agotamiento de memoria. El agente no sabía que esa tabla era grande. - Updates de alcance inesperado: el agente actualiza un registro pensando que es una operación atómica y segura. En realidad, el campo que modifica es una clave foránea que propaga cambios en cascada a otras tres tablas.
La causa no es que el modelo sea deficiente. Es que le diste más poder del que necesitaba para la tarea.
La regla principal: agentes con herramientas, no con conexiones
Los agentes tienen herramientas. Las herramientas tienen conexión a la base de datos.
Esta distinción no es semántica. Es la diferencia entre un agente que puede ejecutar cualquier operación SQL y uno que solo puede ejecutar las operaciones que tú aprobaste explícitamente.
// ❌ Patrón peligroso: el agente genera SQL libre
const tools = {
  query_database: async ({ sql }: { sql: string }) => {
    return await db.query(sql); // el agente puede escribir cualquier cosa aquí
  }
};

// ✅ Patrón seguro: operaciones tipadas con parámetros validados
const tools = {
  get_customer_orders: async ({
    customer_id,
    limit = 10,
  }: {
    customer_id: string;
    limit?: number;
  }) => {
    if (limit > 100) throw new Error('El límite máximo es 100');
    return await readPool.query(
      `SELECT id, status, total, created_at
       FROM orders
       WHERE customer_id = $1
       ORDER BY created_at DESC
       LIMIT $2`,
      [customer_id, limit]
    );
  },

  update_order_status: async ({
    order_id,
    status,
  }: {
    order_id: string;
    status: 'processing' | 'shipped' | 'cancelled';
  }) => {
    const validTransitions: Record<string, string[]> = {
      processing: ['shipped', 'cancelled'],
      shipped: [],
      cancelled: [],
    };
    const current = await readPool.queryOne(
      'SELECT status FROM orders WHERE id = $1',
      [order_id]
    );
    if (!validTransitions[current.status]?.includes(status)) {
      throw new Error(`Transición no válida: ${current.status} → ${status}`);
    }
    return await writePool.query(
      'UPDATE orders SET status = $1, updated_at = NOW() WHERE id = $2',
      [status, order_id]
    );
  },
};
La herramienta get_customer_orders solo puede hacer exactamente eso. No puede filtrar por otro campo. No puede borrar. No puede acceder a otras tablas. El agente no sabe nada sobre el schema de la base de datos — solo conoce las herramientas y sus parámetros.
Separar conexiones de lectura y escritura
Una conexión de base de datos tiene permisos de nivel de usuario en el motor. Si usas la misma conexión para todo, cualquier herramienta tiene acceso a todo. La solución es sencilla: conexiones distintas con permisos distintos.
import { Pool } from 'pg';

// Usuario PostgreSQL con solo SELECT en las tablas necesarias
const readPool = new Pool({
  connectionString: process.env.DATABASE_READONLY_URL,
  max: 10,
});

// Usuario con INSERT/UPDATE limitado a tablas específicas
const writePool = new Pool({
  connectionString: process.env.DATABASE_URL,
  max: 3, // menos conexiones de escritura = menor riesgo de saturación
});
En PostgreSQL, el usuario de lectura se crea en una sola migración:
CREATE USER agent_readonly WITH PASSWORD '...';
GRANT SELECT ON orders, customers, products TO agent_readonly;
-- Sin GRANT INSERT, UPDATE ni DELETE
Cuando el agente intenta operar fuera de sus permisos, la base de datos rechaza la operación antes de ejecutarse. No hace falta lógica extra en el código.
Audit trail: saber qué hizo el agente y cuándo
No es solo para debugging. Es para detectar patrones anómalos antes de que se conviertan en un incidente.
async function auditedTool<T>(
  toolName: string,
  agentId: string,
  sessionId: string,
  params: unknown,
  operation: () => Promise<T>
): Promise<T> {
  const startTime = Date.now();
  try {
    const result = await operation();
    await logAudit({
      toolName,
      agentId,
      sessionId,
      params,
      success: true,
      duration: Date.now() - startTime,
    });
    return result;
  } catch (error) {
    await logAudit({
      toolName,
      agentId,
      sessionId,
      params,
      success: false,
      error: (error as Error).message,
      duration: Date.now() - startTime,
    });
    throw error;
  }
}
Con esto puedes responder en segundos: ¿cuántas escrituras hizo el agente en las últimas 4 horas? ¿Hay un session_id que está haciendo diez veces más queries que la media? ¿Alguna herramienta falla consistentemente con ciertos parámetros?
Validar el impacto antes de ejecutar escrituras masivas
Una operación de escritura sin restricción de alcance puede afectar millones de filas. Antes de ejecutar cualquier mutación de alcance variable, estima el impacto:
const bulk_update_orders = async ({
  filter,
  new_status,
}: {
  filter: { created_before: string };
  new_status: string;
}) => {
  // Primero: contar cuántos registros se verían afectados
  const { count } = await readPool.queryOne<{ count: number }>(
    'SELECT COUNT(*) AS count FROM orders WHERE created_at < $1',
    [filter.created_before]
  );

  if (count > 500) {
    throw new Error(
      `La operación afectaría a ${count} registros. El máximo es 500. Usa un filtro más específico.`
    );
  }

  return await writePool.query(
    'UPDATE orders SET status = $1 WHERE created_at < $2',
    [new_status, filter.created_before]
  );
};
Este patrón "cuenta antes de ejecutar" es especialmente importante cuando el agente recibe instrucciones ambiguas del usuario. El LLM no sabe el volumen de datos — pero tu herramienta sí puede saberlo.
La diferencia entre un agente frágil y uno robusto
En los proyectos de integración IA que construimos para nuestros clientes, los agentes tienen acceso a datos de producción reales. Un fallo de seguridad no rompe solo la aplicación — puede destruir datos irreversiblemente o exponer información confidencial a través del contexto del agente.
La inversión en estos patrones al principio del proyecto es de horas. La recuperación de un incidente en producción puede ser de días o semanas, sin contar el impacto en el negocio.
El 90% de los equipos que llegan a nosotros después de un fallo de agente en producción tenían el mismo problema: le dieron al agente acceso directo a recursos que debían estar protegidos por una capa de herramientas tipadas y auditadas.
Si estás construyendo un agente que accede a tu base de datos, hazte esta pregunta por cada herramienta que defines: ¿qué puede hacer esta función si recibe los parámetros más extremos posibles? Si la respuesta incluye borrar o modificar datos masivamente, tienes un problema de diseño que arreglar antes del primer deploy.
¿Estás construyendo un agente que necesita acceder de forma segura a los datos de tu empresa? Hablemos de cómo diseñarlo desde el principio.