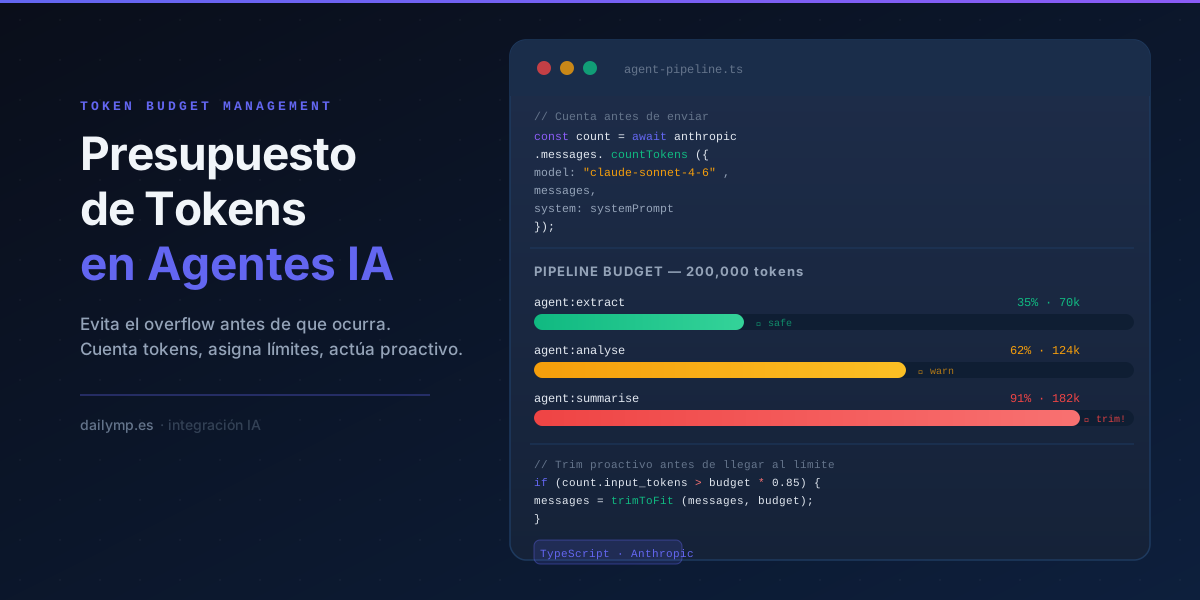
Presupuesto de tokens en agentes IA: evita el overflow
Tres agentes encadenados. El primero extrae datos de un contrato, el segundo analiza cláusulas, el tercero redacta un resumen ejecutivo. En local, sobre documentos de prueba de cuatro páginas, el pipeline funciona a la perfección.
En producción, el primer contrato de cincuenta páginas llega un martes a las 9 de la mañana. El tercer agente lanza un error. O peor: no lanza nada y devuelve una respuesta truncada que nadie detecta hasta que el cliente llama. El contexto explotó y nadie lo vio venir.
El problema que no aparece en los logs
El overflow de contexto en pipelines multi-agente tiene una característica que lo hace especialmente traicionero: no siempre lanza una excepción.
Cuando superas el límite del modelo, el API puede responder con un error context_length_exceeded. Hasta aquí todo normal. Pero en arquitecturas donde cada agente recibe el output del anterior como parte de su contexto, el problema se acumula silenciosamente:
- Agente 1 procesa 40.000 tokens de input. OK.
- Agente 2 recibe el output del primero (3.000 tokens) más el documento original: 43.000 tokens. OK.
- Agente 3 recibe los outputs anteriores más el contexto acumulado: 195.000 tokens. Límite superado.
Si tu código no comprueba el tamaño del contexto antes de llamar al API, te enteras del problema en la respuesta del tercer agente — cuando ya has consumido los créditos de las dos primeras llamadas y el trabajo está a medias.
La solución no es manejar el error cuando ocurre. Es no llegar al error.
Cuenta tokens antes de enviar
La API de Anthropic expone un endpoint de token counting que puedes llamar sin consumir tokens de generación. Cuenta exactamente cuántos tokens ocupará tu mensaje antes de enviarlo.
import Anthropic from "@anthropic-ai/sdk";

const anthropic = new Anthropic();

async function countTokens(
  model: string,
  messages: Anthropic.MessageParam[],
  system?: string
): Promise<number> {
  const response = await anthropic.messages.countTokens({
    model,
    messages,
    ...(system ? { system } : {}),
  });
  return response.input_tokens;
}
Esta llamada es barata — no genera nada, solo cuenta. Úsala como guardia antes de cada llamada al agente:
const MODEL = "claude-sonnet-4-6";
const CONTEXT_LIMIT = 200_000;
const SAFETY_MARGIN = 0.85; // Actúa al llegar al 85% del límite

async function safeAgentCall(
  messages: Anthropic.MessageParam[],
  systemPrompt: string
): Promise<Anthropic.Message> {
  const tokenCount = await countTokens(MODEL, messages, systemPrompt);

  if (tokenCount > CONTEXT_LIMIT * SAFETY_MARGIN) {
    throw new Error(
      `Token budget exceeded: ${tokenCount} / ${CONTEXT_LIMIT} tokens`
    );
  }

  return anthropic.messages.create({
    model: MODEL,
    max_tokens: 8192,
    system: systemPrompt,
    messages,
  });
}
Presupuestos por agente en una pipeline
El patrón anterior lanza un error cuando el agente supera su presupuesto. Pero en una pipeline real, quieres hacer algo más inteligente: recortar el contexto de forma controlada antes de que el agente lo rechace.
Define un presupuesto explícito para cada agente de tu pipeline:
interface AgentBudget {
  name: string;
  maxInputTokens: number;
  onBudgetExceeded: "trim" | "summarize" | "error";
}

const PIPELINE_BUDGETS: AgentBudget[] = [
  { name: "extract",   maxInputTokens: 80_000,  onBudgetExceeded: "trim" },
  { name: "analyse",   maxInputTokens: 100_000, onBudgetExceeded: "summarize" },
  { name: "summarise", maxInputTokens: 60_000,  onBudgetExceeded: "trim" },
];
Con esta estructura, antes de ejecutar cada agente cuentas tokens y, si superas el presupuesto, aplicas la estrategia configurada:
async function runWithBudget(
  budget: AgentBudget,
  messages: Anthropic.MessageParam[],
  system: string
): Promise<Anthropic.Message> {
  let workingMessages = [...messages];
  const tokenCount = await countTokens(MODEL, workingMessages, system);

  if (tokenCount > budget.maxInputTokens) {
    if (budget.onBudgetExceeded === "trim") {
      workingMessages = trimToFit(workingMessages, budget.maxInputTokens, system);
    } else if (budget.onBudgetExceeded === "error") {
      throw new Error(`${budget.name} exceeded budget: ${tokenCount} tokens`);
    }
    // "summarize" → delega a otro agente; ver artículo de context summarization
  }

  return anthropic.messages.create({
    model: MODEL,
    max_tokens: 8192,
    system,
    messages: workingMessages,
  });
}

function trimToFit(
  messages: Anthropic.MessageParam[],
  maxTokens: number,
  system: string,
  target = 0.8
): Anthropic.MessageParam[] {
  // Elimina mensajes más antiguos hasta estar por debajo del 80% del límite
  let trimmed = [...messages];
  while (trimmed.length > 1) {
    // Elimina el mensaje más antiguo que no sea el último (mantén el contexto reciente)
    trimmed = [trimmed[0], ...trimmed.slice(2)];
    // La verificación real requeriría otra llamada a countTokens aquí
    if (trimmed.length <= Math.ceil(messages.length * target)) break;
  }
  return trimmed;
}
Tokens como señal de salud del sistema
Una vez tienes el conteo de tokens por agente, tienes una señal de monitorización gratuita. El tamaño del contexto de un agente refleja la complejidad del documento que está procesando.
Si el agente de análisis empieza a consumir regularmente más de 150.000 tokens en documentos que antes ocupaban 40.000, algo cambió: los documentos son más largos, el system prompt creció, o hay un bug que está pasando información redundante al contexto.
Emite una métrica con cada llamada:
// En tu sistema de telemetría (Datadog, Prometheus, o simplemente logs)
console.log(JSON.stringify({
  event: "agent_call",
  agent: budget.name,
  input_tokens: tokenCount,
  budget_used_pct: Math.round((tokenCount / budget.maxInputTokens) * 100),
  timestamp: new Date().toISOString(),
}));
Una alerta cuando budget_used_pct supera el 80% en el P95 de las llamadas te avisa antes de que el problema llegue a producción. Es el mismo principio que monitorizar uso de disco antes de llenarlo.
El coste de no hacerlo
Sin presupuestos de tokens, tu pipeline tiene dos modos de fallo:
- Error explícito: el API rechaza la llamada. Te enteras, pero ya has consumido créditos en los agentes anteriores.
- Fallo silencioso: el modelo trunca el output o devuelve una respuesta coherente pero incompleta. No te enteras hasta que alguien revisa el resultado manualmente.
En proyectos de integración IA con Anthropic, el segundo caso es el más común y el más costoso. Un sistema que falla en silencio puede llevar semanas produciendo resultados incorrectos antes de que alguien lo detecte.
Si estás construyendo pipelines de agentes para tu empresa, te recomiendo revisar también cómo implementar AI-Driven Development con patrones de resiliencia desde el diseño inicial — es mucho más barato que añadirlos después.
Conclusión
El overflow de contexto en agentes IA no es un problema de error handling: es un problema de arquitectura. Contar tokens antes de enviar, asignar presupuestos explícitos por agente y emitir métricas de uso es lo que separa un pipeline de demostración de uno que funciona en producción durante meses.
La API de token counting no cuesta nada extra. El tiempo de implementación son dos horas. El coste de no hacerlo puede ser semanas de debugging y clientes insatisfechos.
¿Quieres revisar cómo están gestionando el contexto los agentes que ya tienes en producción? Escríbeme por WhatsApp y lo vemos juntos.