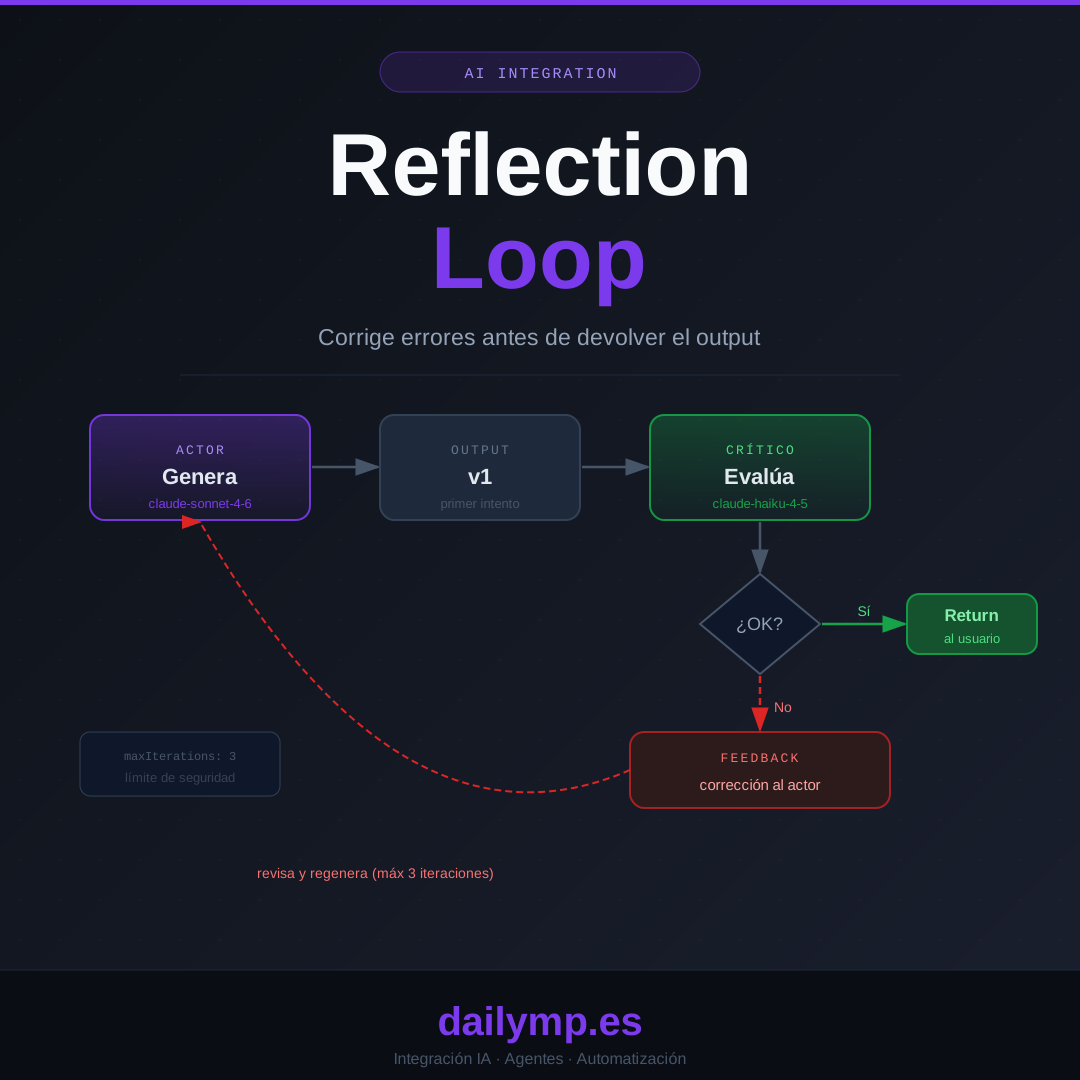
Reflection loops en agentes IA: corrige antes de devolver
Tres de cada diez outputs de tu agente son incorrectos. No de forma obvia: un campo vacío que debería tener valor, un JSON que no parsea, una referencia que no existe en el documento fuente.
El usuario ve el error. Tú también, cuando revisas los logs. Pero el agente ya devolvió el resultado.
El problema no es el modelo. Es la arquitectura. La mayoría de agentes funcionan así: piden un output y lo devuelven. Sin revisión. Sin validación. Sin un segundo par de ojos.
El reflection loop cambia eso.
Por qué el primer intento no basta
Imagina un pipeline de extracción de datos sobre contratos en PDF. El agente extrae fechas, partes, importes y cláusulas clave. En desarrollo, sobre cinco contratos de prueba, la precisión es del 97%.
En producción, con 150 contratos en formatos distintos, empieza a fallar. No siempre. No de forma predecible. Pero falla.
Los patrones de fallo más comunes en agentes de extracción y generación:
- Formato incorrecto: JSON con comillas sin escapar o comas finales que rompen el parse
- Campos incompletos: extrae nueve de diez campos porque el décimo estaba en otra página
- Alucinaciones leves: rellena un campo vacío con un valor plausible pero falso
- Razonamiento truncado: llega a una conclusión correcta por pasos incorrectos
Estos errores comparten algo: el modelo sabe evaluarlos si se los pides, pero no lo hace solo porque nadie se lo pidió.
El patrón reflection: actor + crítico
La arquitectura es simple. Dos roles en un bucle:
Actor: genera el output a partir del input original.
Crítico: evalúa ese output contra un conjunto de criterios explícitos.
Si el crítico aprueba, el output sale hacia el usuario. Si no, el feedback del crítico vuelve al actor para que revise.
Input → Actor → Output v1 → Crítico
                                ↓
                          ¿Supera criterios?
                         /                 \
                        Sí                  No
                        ↓                   ↓
                    Return           Feedback → Actor → Output v2 → ...
El crítico no es un humano. Es el mismo modelo (o uno más pequeño y barato) evaluando el output con un prompt específico: "Revisa este output contra estos criterios. Si algo falla, dime exactamente qué y cómo corregirlo."
Implementación en TypeScript
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic();

interface ReflectionResult {
  output: string;
  iterations: number;
  approved: boolean;
}

async function withReflection(
  actorPrompt: string,
  input: string,
  criteria: string[],
  maxIterations = 3
): Promise<ReflectionResult> {
  let currentOutput = "";
  let iterations = 0;
  let approved = false;

  while (iterations < maxIterations && !approved) {
    // Actor: genera o revisa el output
    const actorContext =
      iterations === 0
        ? `${actorPrompt}\n\nInput:\n${input}`
        : `${actorPrompt}\n\nInput:\n${input}\n\nIntento anterior con feedback:\n${currentOutput}`;

    const actorResponse = await client.messages.create({
      model: "claude-sonnet-4-6",
      max_tokens: 2048,
      messages: [{ role: "user", content: actorContext }],
    });

    currentOutput =
      actorResponse.content[0].type === "text"
        ? actorResponse.content[0].text
        : "";

    // Crítico: evalúa el output con Haiku (más barato)
    const criticPrompt = `Evalúa el siguiente output contra estos criterios:

${criteria.map((c, i) => `${i + 1}. ${c}`).join("\n")}

Output a evaluar:
${currentOutput}

Responde con JSON: { "approved": boolean, "feedback": string, "issues": string[] }
Si "approved" es true, "feedback" e "issues" pueden estar vacíos.`;

    const criticResponse = await client.messages.create({
      model: "claude-haiku-4-5-20251001",
      max_tokens: 512,
      messages: [{ role: "user", content: criticPrompt }],
    });

    const criticText =
      criticResponse.content[0].type === "text"
        ? criticResponse.content[0].text
        : '{"approved":false,"feedback":"Error al evaluar","issues":[]}';

    try {
      const evaluation = JSON.parse(
        criticText.match(/\{[\s\S]*\}/)?.[0] ?? "{}"
      );
      approved = evaluation.approved === true;

      if (!approved) {
        currentOutput = `FEEDBACK DEL REVISOR: ${evaluation.feedback}\nProblemas: ${evaluation.issues?.join(", ")}\n\nOutput previo:\n${currentOutput}`;
      }
    } catch {
      // Si el crítico falla al parsear, aprobamos para no bloquear
      approved = true;
    }

    iterations++;
  }

  return { output: currentOutput, iterations, approved };
}
La clave del diseño: el crítico usa Claude Haiku (más barato y rápido) mientras el actor usa Claude Sonnet. El crítico no necesita generar contenido creativo — solo necesita evaluar contra criterios. Haiku lo hace perfectamente a un coste diez veces menor.
Criterios efectivos para el crítico
El quality del reflection loop depende directamente de los criterios. Criterios vagos producen evaluaciones vagas.
Criterios débiles (no sirven):
- "El output debe ser correcto"
- "La respuesta debe ser completa"
Criterios fuertes (funcionan en producción):
- "El JSON debe parsear sin errores. Verifica que no hay comillas sin escapar, comas finales ni caracteres no válidos."
- "Todos estos campos deben estar presentes y no ser null: fecha_inicio, fecha_fin, importe_total, partes"
- "Cada fecha referenciada debe aparecer en el texto fuente. Si citas una fecha que no está en el input, es una alucinación."
- "El campo
importe_totaldebe ser un número, no un string con símbolo de moneda."
En el servicio de integración IA de DAILYMP los criterios los definimos junto al cliente antes de escribir una línea de código. Son el artefacto más importante del proyecto, más que el propio código.
Cuándo usar reflection (y cuándo no)
Úsalo cuando:
- Los errores tienen coste real: un campo mal extraído genera trabajo manual, una alucinación llega al cliente
- El dominio tiene criterios de corrección verificables (datos estructurados, formatos definidos)
- La latencia adicional (1-3 segundos por iteración) es aceptable
No lo uses cuando:
- La latencia es crítica (chatbots con respuesta en menos de 500ms)
- El output es inherentemente subjetivo (resúmenes creativos, copy de marketing)
- El coste de iteración supera el coste del error
En la práctica, una sola iteración de revisión resuelve el 80% de los fallos comunes. Raramente necesitas más de dos.
El patrón en producción: observabilidad
Añade siempre logging por iteración para detectar patrones de fallo:
console.log({
  event: "reflection_iteration",
  iteration: iterations,
  approved,
  model_actor: "claude-sonnet-4-6",
  model_critic: "claude-haiku-4-5-20251001",
  input_length: input.length,
  output_length: currentOutput.length,
});
Si el 40% de tus contratos necesitan dos o más iteraciones, tienes un problema en el prompt del actor, no en el loop. El loop te está diciendo algo que de otra forma no veías.
Este patrón lo integramos junto con los agentes de automatización empresarial en pipelines de extracción documental, análisis de contratos y generación de informes. Los mismos agentes que en dev tienen 97% de precisión mantienen ese nivel en producción.
El error que comete el 90% de los equipos
Construyen el agente. Lo prueban en dev. Lo despliegan. Cuando falla en prod, ajustan el prompt y vuelven a probar.
El problema: ese ciclo es reactivo. Cada fallo llega al usuario antes de que tú lo veas.
El reflection loop invierte eso: el agente se evalúa solo antes de devolver el resultado. Los fallos se quedan dentro del sistema.
No necesitas un equipo de QA permanente revisando outputs. Necesitas criterios bien definidos y un crítico que los aplique.
¿Estás construyendo un agente que comete errores que el propio modelo podría corregir? En 30 minutos revisamos la arquitectura y vemos si un reflection loop resuelve el problema.