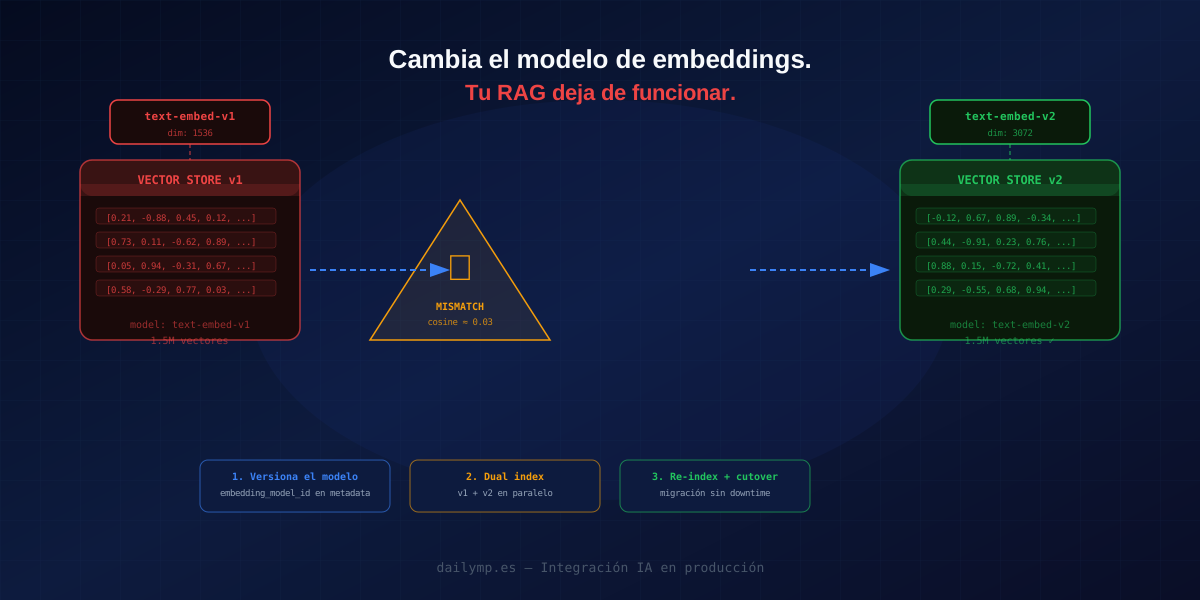
Cambia el modelo de embeddings. Tu RAG falla en silencio.
Llevas tres meses con tu RAG funcionando en producción. Los resultados son buenos. Decides actualizar el modelo de embeddings porque el nuevo es más preciso y más barato.
Haces el deploy. No hay errores. Los tests pasan. El sistema responde.
Pero algo ha cambiado: las respuestas son peores. El agente ya no encuentra los documentos correctos. Los usuarios preguntan cosas que el sistema debería responder y llega a "no encontré información relevante".
No hay una excepción en los logs. No hay un 500. Solo resultados incorrectos que nadie conecta con el cambio que hiciste hace una semana.
Bienvenido al fallo más silencioso en producción con RAG: la incompatibilidad de espacios vectoriales.
Por qué los vectores del modelo anterior son basura ahora
Cuando cambias el modelo de embeddings, el problema no es el modelo nuevo. El problema es que tus vectores almacenados fueron generados por el modelo anterior.
Cada modelo de embeddings proyecta el texto en un espacio vectorial propio. text-embedding-ada-002 de OpenAI tiene dimensiones de 1536. text-embedding-3-large tiene 3072. Los modelos de Voyage AI o Cohere tienen los suyos.
Incluso cuando la dimensionalidad coincide, la geometría del espacio es diferente. El coseno entre dos vectores del mismo modelo mide similaridad semántica. El coseno entre un vector del modelo nuevo y uno del modelo viejo mide ruido estadístico.
Tu sistema no sabe que ha habido un cambio. Convierte la query del usuario con el modelo nuevo. Busca los vectores más cercanos. Y los encuentra — pero esos "vecinos más cercanos" no tienen ninguna relación semántica real con la query.
// El fallo silencioso: query con modelo v2, documentos en modelo v1
const queryEmbedding = await embedWithModel(query, "text-embedding-v2");

// Este coseno no mide nada semántico. Pero no da error.
const results = await vectorDB.similaritySearch(queryEmbedding, topK: 5);
// results tiene registros, todos con baja similaridad real → mal contexto al LLM
El resultado es que el LLM recibe contexto incorrecto y genera respuestas incorrectas. Sin errores, sin alertas, sin nada visible.
Detectar el problema antes de que llegue a producción
La defensa comienza en la metadata de cada vector. Cada documento indexado debe registrar el modelo que generó su embedding:
interface DocumentChunk {
  id: string;
  content: string;
  embedding: number[];
  metadata: {
    source: string;
    embeddingModel: string;  // "text-embedding-ada-002" | "voyage-3" | etc.
    embeddingDim: number;
    indexedAt: string;
  };
}

async function indexDocument(
  content: string,
  source: string,
  model: EmbeddingModel
): Promise<DocumentChunk> {
  const embedding = await model.embed(content);

  return {
    id: crypto.randomUUID(),
    content,
    embedding: embedding.values,
    metadata: {
      source,
      embeddingModel: model.id,
      embeddingDim: embedding.values.length,
      indexedAt: new Date().toISOString(),
    },
  };
}
Con esta metadata puedes detectar incompatibilidades antes de servir:
async function safeSearch(
  query: string,
  currentModel: EmbeddingModel,
  vectorDB: VectorDB
): Promise<SearchResult[]> {
  const queryEmbedding = await currentModel.embed(query);

  // Filtra solo los vectores generados con el modelo actual
  const results = await vectorDB.similaritySearch(queryEmbedding.values, {
    topK: 10,
    filter: {
      embeddingModel: { $eq: currentModel.id },
    },
  });

  if (results.length < 3) {
    // Pocos resultados del modelo actual: probablemente hay un mismatch
    console.warn(`[RAG] Menos de 3 resultados para modelo ${currentModel.id}.
    ¿Se han re-indexado los documentos?`);
  }

  return results;
}
La estrategia de migración: dual index
El error habitual es hacer el re-index de golpe: paras la ingesta, regeneras todos los vectores, cambias el modelo en producción. Durante la migración, el RAG no funciona. Si hay millones de chunks, la ventana es larga.
La estrategia correcta es el dual index: mantener dos colecciones en paralelo mientras dura la migración.
class DualIndexRAG {
  constructor(
    private oldCollection: VectorCollection,  // vectores v1 existentes
    private newCollection: VectorCollection,  // vectores v2 en migración
    private oldModel: EmbeddingModel,
    private newModel: EmbeddingModel,
  ) {}

  async search(query: string): Promise<SearchResult[]> {
    const [oldEmbedding, newEmbedding] = await Promise.all([
      this.oldModel.embed(query),
      this.newModel.embed(query),
    ]);

    const [oldResults, newResults] = await Promise.all([
      this.oldCollection.search(oldEmbedding.values, 10),
      this.newCollection.search(newEmbedding.values, 10),
    ]);

    // Prioriza v2 cuando hay suficientes resultados
    if (newResults.length >= 5) {
      return newResults;
    }
    // Fallback a v1 mientras el re-index no está completo
    return oldResults;
  }
}
Este patrón permite:
- Empezar a indexar documentos con el modelo nuevo mientras el viejo sigue en producción
- Servir con el modelo nuevo solo cuando hay suficiente cobertura
- Completar el re-index en background sin downtime
Para la ingesta durante la migración, indexa cada documento nuevo en ambas colecciones:
async function ingestDuringMigration(
  document: Document,
  dual: DualIndexRAG
): Promise<void> {
  await Promise.all([
    dual.oldCollection.insert(await dual.oldModel.embed(document.content)),
    dual.newCollection.insert(await dual.newModel.embed(document.content)),
  ]);
}
El job de re-index: sin matar producción
El re-index masivo no puede competir con producción por recursos. Necesita rate limiting y paradas limpias:
async function reindexBatch(
  oldCollection: VectorCollection,
  newCollection: VectorCollection,
  newModel: EmbeddingModel,
  opts = { batchSize: 50, delayMs: 200 }
): Promise<{ processed: number; errors: number }> {
  let cursor: string | null = null;
  let processed = 0;
  let errors = 0;

  do {
    const page = await oldCollection.paginate(opts.batchSize, cursor);

    const embeddings = await Promise.allSettled(
      page.items.map(async (doc) => ({
        ...doc,
        embedding: (await newModel.embed(doc.content)).values,
        metadata: {
          ...doc.metadata,
          embeddingModel: newModel.id,
        },
      }))
    );

    for (const result of embeddings) {
      if (result.status === "fulfilled") {
        await newCollection.upsert(result.value);
        processed++;
      } else {
        errors++;
        console.error("[reindex] error en chunk:", result.reason);
      }
    }

    cursor = page.nextCursor;
    if (cursor) await new Promise((r) => setTimeout(r, opts.delayMs));
  } while (cursor !== null);

  return { processed, errors };
}
Con batchSize: 50 y delayMs: 200ms, procesas ~250 documentos/segundo sin saturar la API de embeddings ni ralentizar las queries de producción.
Cuándo hacer el cutover
Antes de desactivar el índice viejo, verifica la cobertura del nuevo con una métrica de migración:
async function checkMigrationCoverage(
  oldCollection: VectorCollection,
  newCollection: VectorCollection
): Promise<{ coverage: number; ready: boolean }> {
  const [oldCount, newCount] = await Promise.all([
    oldCollection.count(),
    newCollection.count(),
  ]);

  const coverage = newCount / oldCount;
  return {
    coverage,
    ready: coverage >= 0.98,  // 98% para hacer cutover
  };
}
El cutover definitivo es cambiar DualIndexRAG para devolver siempre resultados del índice nuevo y programar el borrado del viejo en 24-48h (por si necesitas rollback).
Si tienes un pipeline de integración IA con RAG en producción y el modelo de embeddings nunca ha cambiado, es probable que tarde o temprano lo necesites. Preparar la infraestructura ahora — el versioning de metadata, el dual index, el job de re-index — es mucho más barato que hacerlo bajo presión cuando el RAG ya esté degradado.
En DAILYMP construimos RAG con migración planificada desde el inicio: versioning de modelos, colecciones versionadas y jobs de re-index probados antes de que llegue la primera actualización de modelo.
¿Tienes un RAG en producción que nunca ha pasado por este proceso?