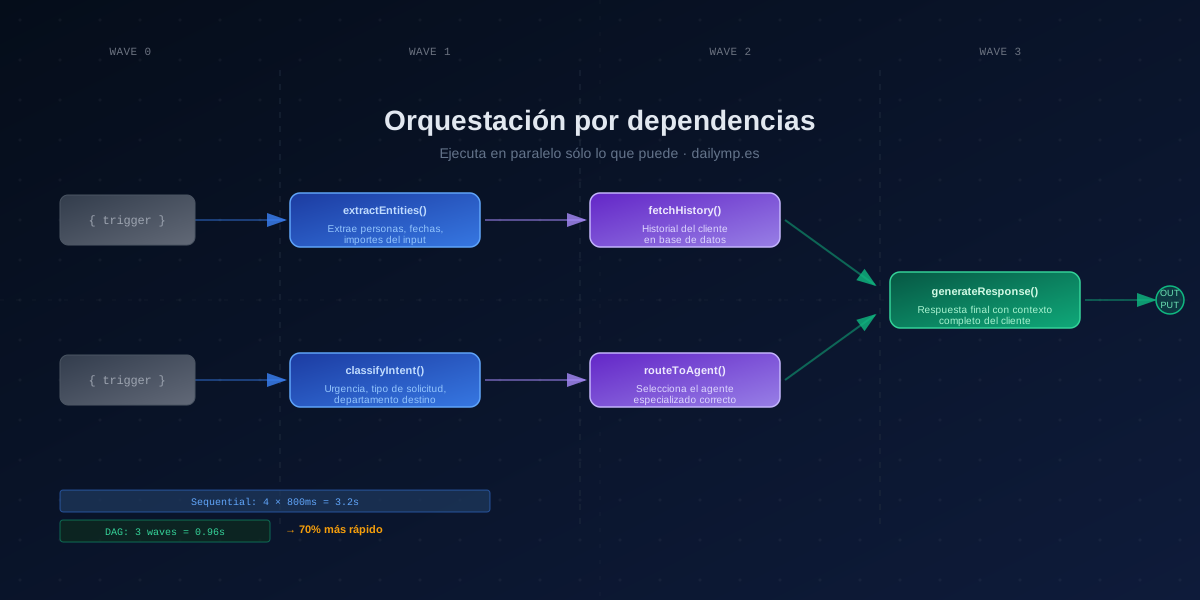
DAG de agentes IA: ejecuta en paralelo sólo lo que puede
Tienes tres tareas que tu agente necesita ejecutar. Dos de ellas pueden arrancar a la vez porque no dependen de nada. La tercera necesita el resultado de ambas. ¿Cómo lo implementas?
La respuesta habitual es una cadena secuencial: A, luego B, luego C. Funciona. Pero si A y B tardan 800ms cada una, estás perdiendo 800ms de tiempo de reloj que podrías haber aprovechado ejecutándolas en paralelo. En un agente que procesa decenas de solicitudes al día, ese desperdicio se acumula.
El otro extremo, lanzar todo con Promise.all, tampoco funciona si C depende del resultado de A y B. Obtienes errores de runtime o, peor, un agente que mezcla contexto incompleto y devuelve respuestas incoherentes.
La solución es un DAG.
Qué es un DAG y por qué importa en agentes IA
DAG son las siglas de Directed Acyclic Graph — un grafo dirigido sin ciclos. En el contexto de orquestación de agentes, cada nodo es una tarea y cada arista indica que una tarea depende del resultado de otra.
La clave es que el DAG resuelve automáticamente el orden de ejecución: agrupa las tareas en "waves" (oleadas). En la primera wave ejecutas todo lo que no tiene dependencias, en paralelo. Cuando terminan, ejecutas la segunda wave — las tareas que sólo dependen de la primera. Y así sucesivamente hasta llegar al nodo final.
El resultado: paralelismo máximo sin romper las dependencias.
Este patrón aparece constantemente en los proyectos de integración de agentes IA que construimos en DAILYMP. En cuanto un workflow tiene más de tres pasos con dependencias distintas, una cadena secuencial deja tiempo y dinero sobre la mesa.
El problema con las cadenas secuenciales
Imagina un agente que procesa la solicitud de soporte de un cliente. Necesita:
- Extraer las entidades del mensaje (nombre, número de contrato, problema)
- Clasificar la intención y la urgencia
- Buscar el historial del cliente en base de datos (necesita el nombre/contrato de paso 1)
- Determinar a qué agente especializado enrutar (necesita la clasificación del paso 2)
- Generar la respuesta final (necesita el historial del paso 3 y el enrutamiento del paso 4)
En cadena secuencial: 5 × ~800ms = 4 segundos.
Con un DAG: los pasos 1 y 2 corren en paralelo (800ms). Cuando terminan, los pasos 3 y 4 corren en paralelo (800ms). Cuando terminan, el paso 5 corre (800ms). Total: 2,4 segundos — el 40% menos de latencia sin cambiar ningún modelo ni optimizar ningún prompt.
Implementación en TypeScript
La estructura base es simple. Cada nodo tiene un identificador, una función ejecutora, y un array de dependencias:
type NodeId = string;

interface DAGNode<T = unknown> {
  id: NodeId;
  deps: NodeId[];
  run: (context: Map<NodeId, unknown>) => Promise<T>;
}

interface DAGResult {
  outputs: Map<NodeId, unknown>;
  durationMs: number;
}
El context es un Map donde cada nodo escribe su resultado al terminar. Los nodos de la siguiente wave lo leen para acceder a los datos que necesitan.
El ejecutor por waves
async function runDAG(nodes: DAGNode[]): Promise<DAGResult> {
  const outputs = new Map<NodeId, unknown>();
  const completed = new Set<NodeId>();
  const start = Date.now();

  // Mientras queden nodos sin ejecutar
  while (completed.size < nodes.length) {
    // Wave actual: nodos cuyas deps están todas completadas
    const wave = nodes.filter(
      (n) =>
        !completed.has(n.id) &&
        n.deps.every((dep) => completed.has(dep))
    );

    if (wave.length === 0) {
      throw new Error("DAG cycle detected — check your dependencies");
    }

    // Ejecutar wave en paralelo
    await Promise.all(
      wave.map(async (node) => {
        const result = await node.run(outputs);
        outputs.set(node.id, result);
        completed.add(node.id);
      })
    );
  }

  return { outputs, durationMs: Date.now() - start };
}
Treinta líneas. Sin librerías externas. Este es el núcleo.
Uso real: el agente de soporte
const pipeline: DAGNode[] = [
  {
    id: "extract",
    deps: [],
    run: async () => extractEntities(userMessage),
  },
  {
    id: "classify",
    deps: [],
    run: async () => classifyIntent(userMessage),
  },
  {
    id: "history",
    deps: ["extract"],
    run: async (ctx) => {
      const { customerId } = ctx.get("extract") as ExtractResult;
      return fetchCustomerHistory(customerId);
    },
  },
  {
    id: "route",
    deps: ["classify"],
    run: async (ctx) => {
      const { intent, urgency } = ctx.get("classify") as ClassifyResult;
      return resolveTargetAgent(intent, urgency);
    },
  },
  {
    id: "respond",
    deps: ["history", "route"],
    run: async (ctx) => {
      const history = ctx.get("history") as CustomerHistory;
      const agent = ctx.get("route") as AgentRoute;
      return generateResponse(userMessage, history, agent);
    },
  },
];

const { outputs, durationMs } = await runDAG(pipeline);
const response = outputs.get("respond") as string;
El código describe las dependencias de forma declarativa. El ejecutor resuelve el orden. Si mañana añades un nuevo nodo que no depende de nada, se ejecutará en paralelo con extract y classify sin tocar el resto.
Gestión de errores: fallo parcial vs. fallo total
Por defecto, si un nodo falla, Promise.all rechaza la wave entera. A veces eso es lo que quieres. Pero hay casos donde el fallo de un nodo no debería bloquear otros nodos independientes.
La solución es capturar errores por nodo y decidir en cada caso:
// En el map de la wave, capturar errores opcionalmente
await Promise.all(
  wave.map(async (node) => {
    try {
      const result = await node.run(outputs);
      outputs.set(node.id, result);
      completed.add(node.id);
    } catch (err) {
      if (node.optional) {
        outputs.set(node.id, null);
        completed.add(node.id);
      } else {
        throw err; // Propaga y cancela el DAG
      }
    }
  })
);
Añade un flag optional: true a los nodos que pueden fallar sin romper el resultado final. Los nodos críticos propagan el error y detienen la ejecución. Esto te da control granular sobre la tolerancia a fallos del pipeline.
Cuándo usar DAG y cuándo no
El DAG paga su coste conceptual cuando:
- Tienes 3 o más tareas con dependencias parciales entre ellas
- Las tareas individuales tienen latencia medible (llamadas a LLM, base de datos, APIs externas)
- El workflow va a escalar — más nodos en el futuro son inevitables
No lo uses cuando:
- Tienes 2 tareas que siempre van en orden — una cadena simple es más legible
- Todas las tareas dependen de la anterior — es una cadena, no un grafo
- La latencia de cada tarea es < 50ms — el overhead de coordinación no merece la pena
El error que cometen la mayoría
Intentar paralelizar sin modelar las dependencias. Hacen Promise.all sobre todas las tareas y luego, cuando un nodo necesita el resultado de otro, lo resuelven con flags, variables compartidas o reordenando el array a mano. El resultado es código frágil que nadie entiende tres meses después.
Un DAG hace ese contrato explícito. Las dependencias son datos, no lógica de control escondida. Cuando un nuevo miembro del equipo lee el array de nodos, ve exactamente qué depende de qué sin tener que trazar el flujo de ejecución.
En los proyectos de AI Driven Development que construimos en DAILYMP, este patrón es uno de los primeros que instalamos en cualquier agente con más de tres pasos. La diferencia de latencia es inmediata. La diferencia en mantenibilidad, todavía mayor.
¿Estás construyendo un agente con pasos encadenados y ya notas que tarda demasiado? Cuéntame en WhatsApp qué pipeline tienes y en 30 minutos te digo cómo modelarlo como DAG y cuánto puedes ganar en latencia.