Agentes IA y RGPD: Procesa Datos Sensibles sin Exponerlos
Tu agente IA acaba de procesar un contrato con el nombre completo, el DNI y el número de cuenta bancaria de tu cliente. Luego envió todo ese texto —sin cifrar, como payload JSON— a los servidores de Anthropic en California.
¿Tienes base legal documentada para esa transferencia internacional de datos? ¿Has hecho el análisis de impacto que exige el RGPD para tratamientos de alto riesgo?
La mayoría de equipos que integran LLMs en procesos de negocio no se hacen esta pregunta hasta que alguien del departamento legal la hace. Y cuando eso ocurre, la respuesta más común es parar el sistema o reconstruirlo desde cero.
El problema que nadie ve hasta que explota
Cuando construyes un agente IA que procesa documentos —contratos, facturas, emails de clientes, historiales de soporte— ese agente envía el contenido al proveedor del LLM para que lo procese. Eso significa que datos personales de tus clientes viajan a infraestructura de terceros.
El Reglamento General de Protección de Datos exige que tengas base legal para ese tratamiento y, si los datos salen de la UE, que existan garantías adecuadas: cláusulas contractuales tipo, o que el receptor esté en un país con nivel adecuado de protección.
Anthropic, OpenAI y la mayoría de proveedores de LLMs ofrecen DPAs (Data Processing Agreements) y se comprometen a no usar los datos de la API para entrenar sus modelos. Eso cubre parte del problema, pero no lo cubre todo:
- Tu responsabilidad no desaparece por firmar un DPA — sigues siendo responsable como responsable del tratamiento
- El principio de minimización obliga a no enviar más datos de los necesarios para el fin concreto
- Sectores regulados (banca, sanidad, seguros) tienen restricciones adicionales que un DPA genérico no cubre
La pregunta técnica es: ¿puedes hacer que tu agente haga su trabajo sin que el LLM llegue a ver los datos personales?
En la mayoría de casos, sí.
El patrón: PII Redaction como capa de seguridad para agentes IA con RGPD
La solución es un pipeline de anonimización que actúa como intermediario entre tu sistema y el LLM:
- Detección: el texto de entrada se escanea para identificar entidades PII (nombres, DNIs, IBANs, emails, teléfonos, direcciones)
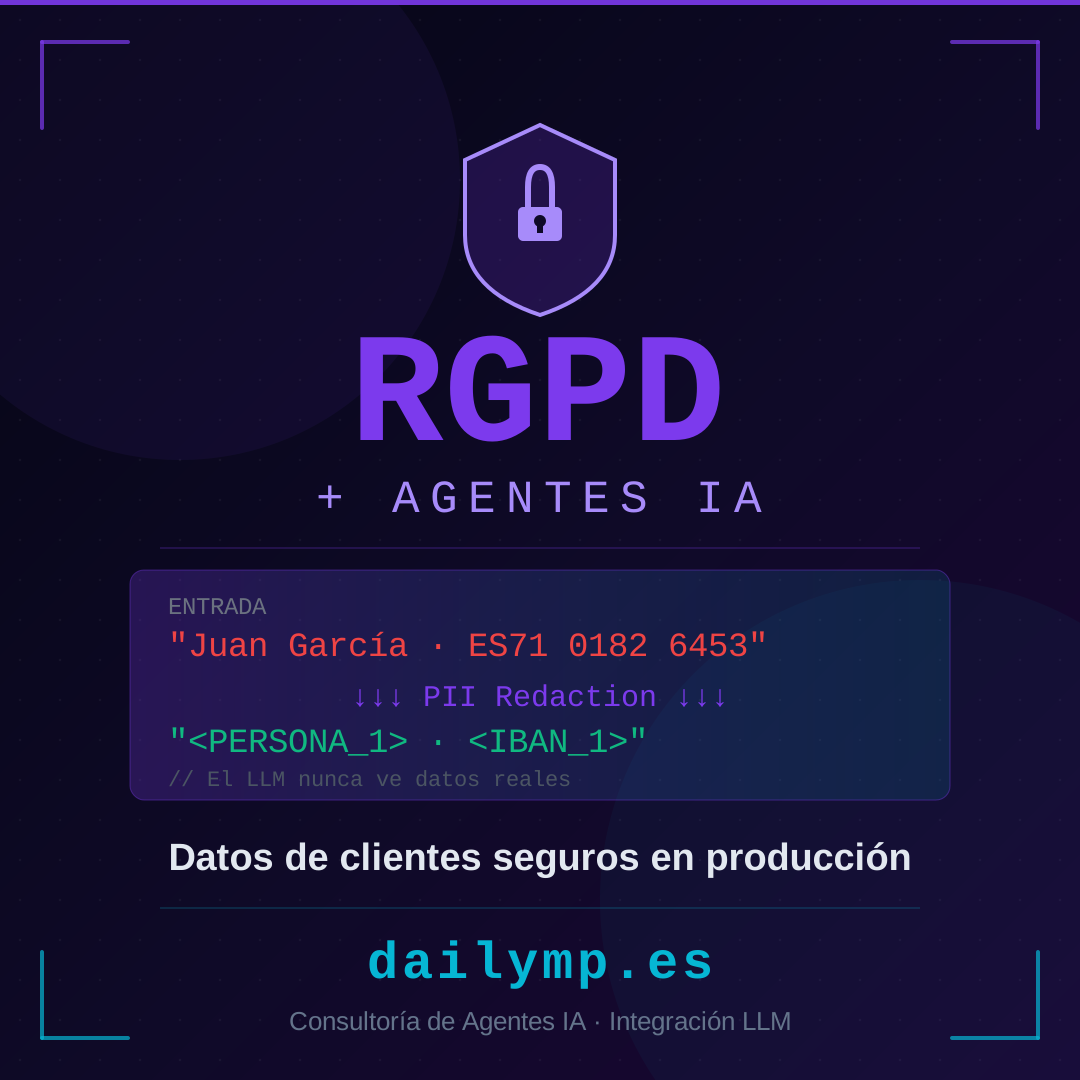
- Sustitución: cada entidad se reemplaza por un token pseudónimo:
"Juan García"→<PERSONA_1>,"ES71 0182 6453"→<IBAN_1> - Procesamiento: el texto anonimizado se envía al LLM, que hace su análisis sin ver datos reales
- Re-inserción: el output del LLM contiene los mismos tokens, que se sustituyen de vuelta por los valores originales
El LLM nunca ve datos personales reales. Tu sistema mantiene la tabla de correspondencia token ↔ valor real en memoria durante la sesión y la aplica al final.
Implementación en TypeScript con Microsoft Presidio
La librería más usada en producción para esto es Microsoft Presidio (open source), disponible como servidor REST en Python. Desde tu aplicación Next.js o Node.js, la llamas como cualquier microservicio:
type PiiEntity = {
  start: number;
  end: number;
  entity_type: string;
  score: number;
};

type RedactionMap = Map<string, string>;

async function redactPii(text: string): Promise<{
  redacted: string;
  map: RedactionMap;
}> {
  const entities: PiiEntity[] = await fetch(
    "http://presidio-analyzer:5002/analyze",
    {
      method: "POST",
      headers: { "Content-Type": "application/json" },
      body: JSON.stringify({ text, language: "es" }),
    }
  ).then((r) => r.json());

  const sorted = entities
    .filter((e) => e.score > 0.7)
    .sort((a, b) => b.start - a.start);

  const map: RedactionMap = new Map();
  const counters: Record<string, number> = {};
  let redacted = text;

  for (const entity of sorted) {
    const original = text.slice(entity.start, entity.end);
    counters[entity.entity_type] = (counters[entity.entity_type] ?? 0) + 1;
    const token = `<${entity.entity_type}_${counters[entity.entity_type]}>`;
    map.set(token, original);
    redacted =
      redacted.slice(0, entity.start) + token + redacted.slice(entity.end);
  }

  return { redacted, map };
}

function reinsertPii(text: string, map: RedactionMap): string {
  let result = text;
  for (const [token, original] of map) {
    result = result.replaceAll(token, original);
  }
  return result;
}

async function processContractSafely(contractText: string) {
  const { redacted, map } = await redactPii(contractText);

  const response = await anthropic.messages.create({
    model: "claude-opus-5-5",
    max_tokens: 1024,
    messages: [
      {
        role: "user",
        content: `Extrae las cláusulas clave de este contrato:\n\n${redacted}`,
      },
    ],
  });

  const rawOutput =
    response.content[0].type === "text" ? response.content[0].text : "";

  return reinsertPii(rawOutput, map);
}
Para equipos que no quieren gestionar un microservicio externo, los patrones regex cubren los tipos de PII más comunes en España:
const PII_PATTERNS_ES: Record<string, RegExp> = {
  DNI: /\b\d{8}[A-HJ-NP-TV-Z]\b/g,
  NIE: /\b[XYZ]\d{7}[A-HJ-NP-TV-Z]\b/g,
  IBAN: /\bES\d{2}[\s]?\d{4}[\s]?\d{4}[\s]?\d{4}[\s]?\d{4}[\s]?\d{4}\b/g,
  PHONE: /\b(?:\+34[\s-]?)?[6-9]\d{8}\b/g,
  EMAIL: /\b[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}\b/g,
};
La limitación del enfoque regex es que no detecta nombres propios ni direcciones físicas. Para eso, Presidio con su modelo de NER (Named Entity Recognition) da resultados mucho más robustos.
Lo que el RGPD realmente exige en el contexto de agentes IA
Es importante no sobreingenierar la solución. El RGPD no prohíbe usar LLMs para procesar datos personales — exige que tengas base legal y que apliques medidas técnicas apropiadas al nivel de riesgo.
Para la mayoría de casos de uso empresarial (contratos, emails, facturas), la pseudonimización es suficiente como medida técnica si además:
- Tienes un DPA firmado con tu proveedor LLM
- Documentas el análisis de impacto (DPIA) para tratamientos de alto riesgo
- Limitas el tiempo de retención en los logs del LLM
- Tienes un registro del tratamiento actualizado
Para sectores regulados (banca, sanidad, seguros) los requisitos son más estrictos. En algunos casos es necesario usar modelos desplegados en infraestructura propia o dentro de la UE. Si estás construyendo un agente de automatización IA para uno de estos sectores, el análisis de cumplimiento forma parte del diseño de arquitectura, no de los últimos sprints antes del lanzamiento.
Resultado real de implementarlo desde el principio
Los equipos que implementan este pipeline antes de escalar sus agentes ahorran semanas de trabajo reactivo cuando llega la primera auditoría o una solicitud de acceso por parte de un cliente.
El coste de hacerlo bien desde el principio es un sprint. El coste de arreglarlo cuando ya hay datos en producción es un proyecto.
Si tienes una integración IA que procesa documentos con datos de clientes y quieres blindar la arquitectura desde el principio, hablemos.