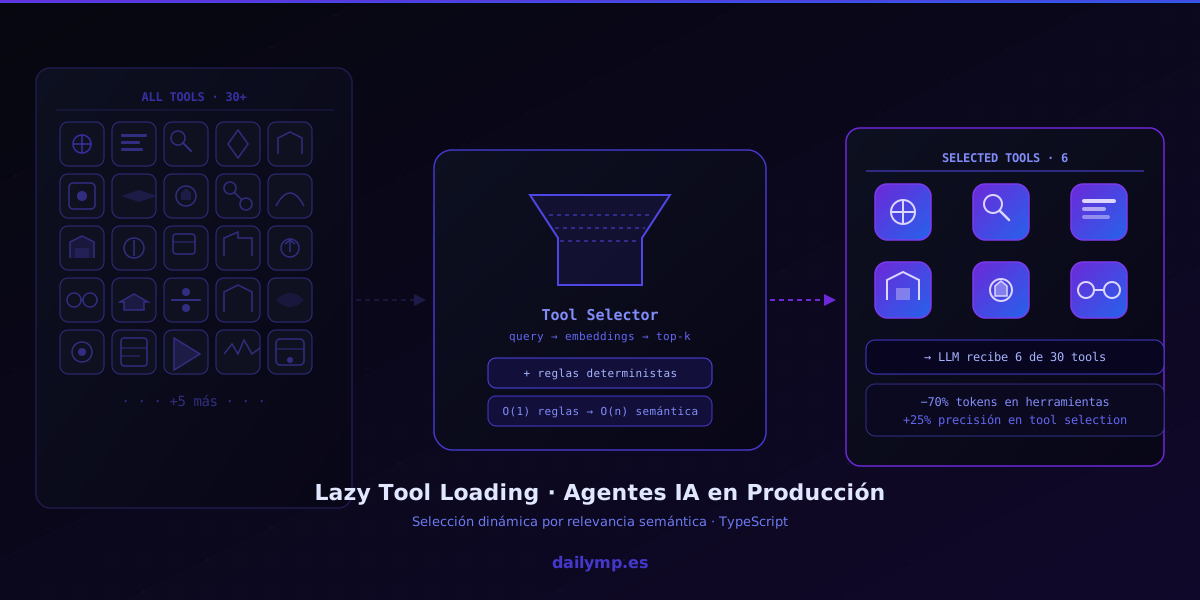
Lazy tool loading en agentes IA: contexto y precisión
Tienes un agente con 30 herramientas. Un CRM, una base de datos, cuatro endpoints del ERP, un buscador semántico, funciones para enviar emails, crear tareas, actualizar registros...
Cuando el usuario escribe "¿cuándo es la próxima revisión del contrato de Acme?", tu agente carga las 30 herramientas en el contexto y se las pasa al LLM completas.
El modelo tiene que leer cada definición, elegir la correcta y decidir cómo usarla. Con 30 tools, eso son 4.000–6.000 tokens extra por llamada. Si el agente atiende 500 consultas al día, estás pagando 2–3 millones de tokens al mes solo en el payload de herramientas. Y eso cuando las cosas van bien.
El problema real es que con demasiadas opciones, el modelo elige mal.
Por qué demasiadas herramientas confunden al LLM
Los modelos actuales eligen bien entre 5–8 opciones diferenciadas. Con 30 herramientas pasan tres cosas concretas:
Colisiones semánticas. Si tienes search_contracts, get_contract_by_id, list_active_contracts y find_expired_contracts, el modelo elige la herramienta incorrecta aunque el resultado sea similar. No porque no entienda la diferencia: la consulta del usuario raramente es precisa sobre qué variante necesita.
Attention dilution. El transformer presta atención distribuida a todo el contexto. Con 30 definiciones en el prompt, la atención dedicada a razonar sobre la consulta real baja. Las instrucciones de sistema y las tools compiten con el razonamiento.
Sobreconfianza en tools irrelevantes. El modelo ve una función de envío de emails y, aunque el usuario solo haya preguntado por un contrato, a veces decide "por si acaso" incluir un paso de notificación que nadie pidió.
La solución no es tener menos herramientas. Es cargar solo las relevantes para cada consulta.
El patrón: tool registry + selección semántica
La arquitectura tiene tres capas:
- Tool registry: catálogo completo con definiciones y metadatos de todas las herramientas
- Tool selector: dado el contexto de la consulta, devuelve las herramientas relevantes
- Tool loader: construye el prompt final solo con las herramientas seleccionadas
Tool registry en TypeScript
interface ToolDefinition {
  name: string;
  description: string;
  inputSchema: object;
  tags: string[];        // para filtrado por dominio
  embedding?: number[];  // precalculado al arrancar
}

class ToolRegistry {
  private tools = new Map<string, ToolDefinition>();

  register(tool: ToolDefinition) {
    this.tools.set(tool.name, tool);
  }

  getAll(): ToolDefinition[] {
    return [...this.tools.values()];
  }

  getByTags(tags: string[]): ToolDefinition[] {
    return this.getAll().filter((t) =>
      t.tags.some((tag) => tags.includes(tag))
    );
  }
}
Selector semántico
Embeds la consulta del usuario y la comparas con los embeddings de cada herramienta:
async function selectTools(
  query: string,
  registry: ToolRegistry,
  maxTools = 6
): Promise<ToolDefinition[]> {
  const queryEmbedding = await embed(query);

  const scored = registry.getAll().map((tool) => ({
    tool,
    score: cosineSimilarity(queryEmbedding, tool.embedding!),
  }));

  return scored
    .sort((a, b) => b.score - a.score)
    .slice(0, maxTools)
    .map((s) => s.tool);
}
Los embeddings de las herramientas se precalculan al arrancar el servidor y se guardan en memoria. Solo se recalculan cuando añades una tool nueva.
Combinar con reglas deterministas
Para intenciones frecuentes y conocidas, las reglas son más rápidas y predecibles que la búsqueda semántica:
const INTENT_RULES: Record<string, string[]> = {
  contract: ["search_contracts", "get_contract_detail", "list_active_contracts"],
  email:    ["send_email", "get_email_template", "list_email_drafts"],
  crm:      ["search_customer", "update_customer", "create_contact"],
};

function rulesBasedPreselect(query: string): string[] | null {
  const lower = query.toLowerCase();
  for (const [intent, tools] of Object.entries(INTENT_RULES)) {
    if (lower.includes(intent)) return tools;
  }
  return null;
}

async function getToolsForQuery(
  query: string,
  registry: ToolRegistry
): Promise<ToolDefinition[]> {
  // Reglas primero: O(1), sin llamada a la API de embeddings
  const rulesResult = rulesBasedPreselect(query);
  if (rulesResult) {
    return rulesResult
      .map((name) => registry.get(name))
      .filter((t): t is ToolDefinition => t !== undefined);
  }
  // Fallback: selección semántica
  return selectTools(query, registry);
}
El flujo es exactamente ese: reglas exactas primero (rápido, sin coste), luego semántica para los casos no previstos. En producción, el 70–80% de las consultas cae en reglas conocidas.
Resultados en proyectos reales
En los agentes que construimos en DAILYMP con esta arquitectura:
- 60–70% menos tokens en el payload de herramientas por llamada
- 15–25% de mejora en precisión de tool selection (menos "elegí la tool incorrecta")
- Latencia reducida porque el LLM procesa un contexto más compacto
El impacto más importante no es económico: es la calidad. Un agente con 30 herramientas que carga las 6 más relevantes responde mejor que uno que carga las 30 y a veces se pierde eligiendo.
Este patrón es uno de los primeros que instalamos cuando un agente empieza a crecer en número de integraciones. Lo aplicamos directamente en los proyectos de integración de agentes IA para operaciones empresariales: cuando el agente toca ERP, CRM, base de datos de contratos y sistema de tickets al mismo tiempo, la selección de herramientas es tan importante como el prompt principal.
Cuándo implementarlo y cuándo no
Vale la pena cuando:
- Tienes más de 10–12 herramientas en el agente
- Las herramientas cubren dominios semánticos distintos (finanzas, RRHH, logística, comunicación)
- El coste o la latencia ya son una preocupación en producción
No lo implementes si:
- Tienes 5–6 herramientas muy distintas — cárgalas todas y simplifica el código
- Todas las tools son del mismo dominio — el modelo no se confunde tanto
- La selección incorrecta tiene consecuencias graves — es mejor cargar de más con instrucciones claras
El overhead de implementación es bajo: un tool registry, una función de selección y los embeddings precalculados al arrancar. El tiempo de setup cabe en una tarde; el impacto en costes y calidad se nota desde el primer día.
El error más común al escalar un agente
La mayoría de los equipos añaden herramientas sin replantearse la arquitectura de carga. Empiezan con 5 tools, llegan a 20, y siguen cargándolas todas porque "funciona". Cuando la precisión cae o el coste sube, lo atribuyen al modelo en lugar de al contexto.
Este es exactamente el tipo de problema que resolvemos en proyectos de AI Driven Development: no cambiar el modelo, sino arreglar la arquitectura de cómo el modelo recibe la información.
¿Cuántas herramientas tiene tu agente ahora mismo? Si ya superas las 10 y notas que el modelo elige mal o que el coste por llamada empieza a importar, cuéntamelo.