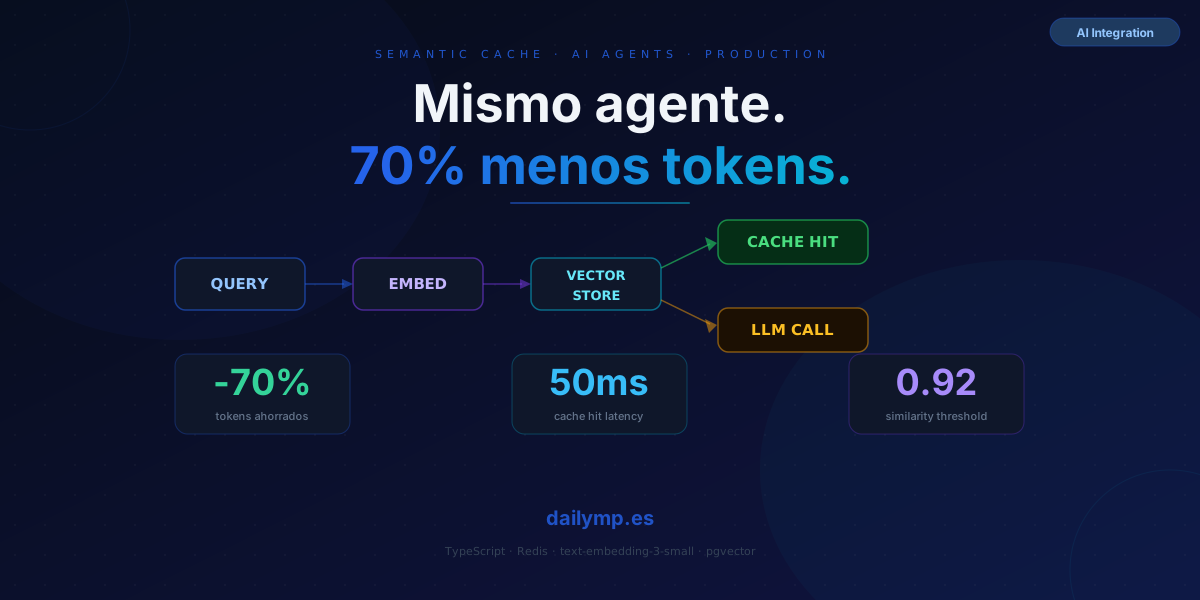
Semantic Cache: Tu Agente IA Más Rápido y Más Barato
Tu agente de soporte lleva meses respondiendo la misma pregunta cuarenta veces al día. "¿Cómo cambio mi contraseña?" "¿Cuánto tarda el envío?" "¿Puedo cancelar mi pedido?" Cada respuesta cuesta tokens. Cada token cuesta dinero. Y estás pagando por una conversación que ya tuviste, literalmente, ayer.
El semantic cache corta ese gasto sin que el usuario note la diferencia.
Qué es un semantic cache y por qué el caché tradicional no funciona aquí
Un caché tradicional almacena resultados por clave exacta: getWeather("Madrid") → guarda "18°C". Funciona para datos deterministas. Para un LLM, no: "¿Cómo cambio la contraseña?" y "quiero actualizar mi contraseña" son strings distintos con intención idéntica. El caché de clave exacta ignora esa similitud y llama al LLM dos veces.
Un semantic cache usa embeddings para medir similitud de significado:
- Conviertes la query del usuario en un vector (embedding)
- Buscas en el store si hay queries previas con alta similitud coseno
- Si la similitud supera el umbral, devuelves la respuesta cacheada
- Si no, llamas al LLM, guardas la respuesta, y la sirves
El usuario ve la respuesta en 50ms en vez de 800ms. No gastas tokens. Los dos ganáis.
Implementación base en TypeScript
La estructura mínima con OpenAI embeddings y Redis. El mismo patrón funciona con pgvector si ya tienes Postgres:
import OpenAI from 'openai'
import { Redis } from 'ioredis'
import { cosineSimilarity } from './utils'

const openai = new OpenAI()
const redis = new Redis(process.env.REDIS_URL!)

interface CacheEntry {
  queryEmbedding: number[]
  response: string
  createdAt: number
}

async function getEmbedding(text: string): Promise<number[]> {
  const { data } = await openai.embeddings.create({
    model: 'text-embedding-3-small',
    input: text,
  })
  return data[0].embedding
}

async function semanticCacheLookup(
  query: string,
  threshold = 0.92,
  ttlSeconds = 3600
): Promise<string | null> {
  const queryEmbedding = await getEmbedding(query)
  const keys = await redis.keys('sc:*')

  for (const key of keys) {
    const raw = await redis.get(key)
    if (!raw) continue

    const entry: CacheEntry = JSON.parse(raw)
    if (Date.now() - entry.createdAt > ttlSeconds * 1000) {
      await redis.del(key)
      continue
    }

    const sim = cosineSimilarity(queryEmbedding, entry.queryEmbedding)
    if (sim >= threshold) return entry.response
  }

  return null
}

async function cacheStore(query: string, response: string): Promise<void> {
  const queryEmbedding = await getEmbedding(query)
  const entry: CacheEntry = { queryEmbedding, response, createdAt: Date.now() }
  await redis.set(`sc:${Date.now()}`, JSON.stringify(entry), 'EX', 3600)
}
Y así queda integrado en tu agent loop:
async function agentWithCache(userMessage: string): Promise<string> {
  const cached = await semanticCacheLookup(userMessage)
  if (cached) return cached // 50ms, cero tokens

  const response = await callLLM(userMessage) // 800ms, tokens completos
  await cacheStore(userMessage, response)
  return response
}
Dos caminos. Uno cuesta. El otro no.
El parámetro que todos configuran mal: el umbral de similitud
El threshold (0.92 en el ejemplo) es el punto crítico. La mayoría de equipos lo deja en 0.95 "para ser seguros" y el caché casi nunca tiene hit. O lo bajan a 0.85 y el agente empieza a devolver respuestas incorrectas para preguntas parecidas pero distintas.
Cómo calibrarlo sin adivinar:
- Recoge 500-1.000 queries reales de tu sistema
- Genera embeddings y mide similitud entre pares
- Clasifica manualmente cuáles son "la misma intención" y cuáles no
- El umbral óptimo está donde el F1-score (precisión × recall) es máximo
Para soporte al cliente genérico, 0.92–0.94 suele funcionar. Para queries técnicas o que requieren datos en tiempo real, el semantic cache no es la herramienta — ver sección siguiente.
Invalidación: el problema de las respuestas que caducan
Los TTL por tiempo son el mínimo viable, no la solución. Si cambias tu política de devoluciones, el caché puede servir la respuesta antigua durante horas.
Estrategia recomendada: cache keys por categoría semántica. Cuando hay un cambio, invalidas solo la categoría afectada en lugar de esperar a que expire el TTL:
// Invalidación quirúrgica por categoría
await redis.del(...await redis.keys('sc:devoluciones:*'))

// vs. esperar TTL = hasta 1h sirviendo datos obsoletos
Añadir un prefijo de categoría al key (sc:${category}:${Date.now()}) requiere un clasificador ligero (un modelo pequeño o una lista de triggers) antes del lookup, pero te da control total sobre la invalidación.
Cuándo NO usar semantic cache
El semantic cache tiene sentido para respuestas que son independientes del usuario, relativamente estáticas y sin datos en tiempo real.
No lo uses para:
- Queries personalizadas que dependen del historial del usuario
- Respuestas que incluyen datos de APIs externas en tiempo real (precios live, estado de pedido, stock)
- Agentes de razonamiento multistep donde el contexto de la sesión importa
Si tu agente mezcla preguntas cacheables y no cacheables, añade un clasificador antes del lookup:
const NON_CACHEABLE = ['mi pedido', 'mi cuenta', 'estado de', 'precio actual']

function isCacheable(query: string): boolean {
  return !NON_CACHEABLE.some(t => query.toLowerCase().includes(t))
}

async function agentWithSmartCache(userMessage: string): Promise<string> {
  if (isCacheable(userMessage)) {
    const cached = await semanticCacheLookup(userMessage)
    if (cached) return cached
  }

  const response = await callLLM(userMessage)
  if (isCacheable(userMessage)) await cacheStore(userMessage, response)
  return response
}
Resultados reales: qué esperar
En agentes de soporte con volumen medio (2.000-5.000 queries/día), un semantic cache bien configurado típicamente reduce entre el 40% y el 70% de las llamadas al LLM. La distribución sigue una ley de potencia: un número pequeño de preguntas muy repetidas acumula la mayor parte del gasto en tokens.
El coste de un embedding (text-embedding-3-small) es ~20x menor que el de una respuesta completa. El ratio es favorable siempre que el hit rate supere el 10-15%.
En los proyectos de integración de agentes IA que implementamos en DAILYMP, añadir semantic cache fue una de las primeras optimizaciones en producción: el coste mensual cayó antes de necesitar otras medidas. Si ya tienes un agente funcionando y el coste escala rápido con el uso, esta es la palanca más directa.
Puedes combinar este patrón con model routing en tu agente: queries simples van al caché, queries medias a un modelo pequeño, queries complejas al modelo potente. Tres capas de optimización de coste apiladas.
Siguiente paso
Implementar semantic cache en un agente existente lleva entre 2 y 4 horas con Redis disponible. El ROI es inmediato y medible: comparas coste de tokens antes y después en la factura del mes siguiente.
Si quieres revisar el diseño de tu agente en producción — coste, latencia, arquitectura — escríbeme directamente.