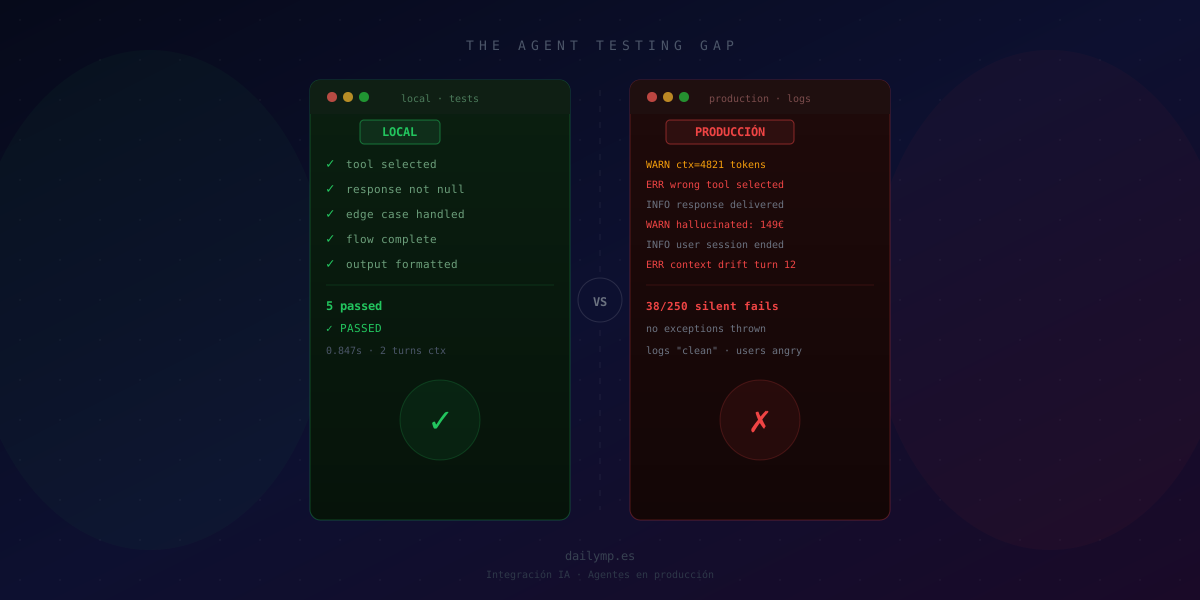
Tus agentes IA pasan los tests. Luego fallan en producción.
Tus agentes pasan todas las pruebas locales. Llegan a producción y empiezan a fallar de formas que no puedes reproducir, que no aparecen en tus logs y que el equipo tarda horas en entender.
Este es el problema de testing más ignorado en proyectos de IA en 2026: los agentes no se rompen como el software clásico. Se degradan. Dan respuestas que técnicamente no son excepciones pero están mal. Toman decisiones incorrectas en contextos que nunca viste durante el desarrollo.
Por qué los tests unitarios no funcionan con agentes LLM
Cuando testeas una función en TypeScript, el resultado es determinista. add(2, 3) siempre devuelve 5. Puedes escribir expect(result).toBe(5) y dormirte tranquilo.
Los agentes LLM no funcionan así. El mismo prompt con el mismo contexto puede devolver respuestas ligeramente distintas cada vez. La temperatura por defecto ya garantiza variabilidad. Y eso es el problema menor.
El problema mayor es que la mayoría de los fallos de agentes en producción no son excepciones. Son:
- El agente usa la herramienta equivocada porque el contexto tiene 3.000 tokens más de los que tenías en local
- El agente "alucina" una respuesta plausible cuando debería haber devuelto
null - La cadena de razonamiento funciona con tus datos de prueba y se rompe con datos reales de producción
- El agente elige el camino A en lugar del B, y el usuario no se queja, simplemente no vuelve
// Lo que tests clásicos verifican:
expect(agent.response).not.toBeNull()       // ✅ pasa siempre
expect(agent.toolCalled).toBe('search')     // ✅ pasa en local

// Lo que necesitas verificar pero no puedes con expect():
// ¿La respuesta es CORRECTA para el caso de uso real?
// ¿El razonamiento tiene sentido con datos reales del usuario?
// ¿El agente elige bien con contexto largo de producción?
Los tres fallos más comunes que solo aparecen en producción
1. Context drift: el agente se pierde en conversaciones largas
En desarrollo testeas con 2-3 turnos de conversación. En producción, un usuario lleva 15 mensajes en el hilo. El agente empieza a contradecirse, a "olvidar" las instrucciones del sistema o a comportarse como si las herramientas disponibles fueran otras.
La causa: la ventana de contexto se llena y el LLM empieza a prestar menos atención a las instrucciones iniciales. Ningún test unitario lo captura porque nunca simulas conversaciones largas con datos de usuarios reales.
// Patrón que rompe en producción con contexto largo:
const messages = [
  { role: 'system', content: systemPrompt }, // 800 tokens
  ...conversationHistory,                     // 3000+ tokens — las instrucciones se diluyen
  { role: 'user', content: currentMessage }
]

// Patrón más robusto:
function buildMessages(history: Message[], systemPrompt: string) {
  const compressedHistory = compressToTokenBudget(history, 2000)
  return [
    { role: 'system', content: systemPrompt },
    ...compressedHistory,
    { role: 'user', content: history.at(-1)!.content }
  ]
}
2. Tool selection failure: elige la herramienta incorrecta
Le das al agente 8 herramientas. En local, con tus preguntas de prueba perfectamente formuladas, siempre elige bien. En producción, con preguntas de usuarios reales, elige la herramienta A cuando debería elegir la B.
La raíz del problema casi siempre está en las descripciones de las herramientas. Cuando dos tienen descripciones ambiguas o solapadas, el LLM elige según el orden de aparición o la longitud de la descripción, no según la lógica.
// Descripción que confunde al LLM (mismo vocabulario):
{ name: 'get_customer_info', description: 'Gets information about a customer' }
{ name: 'search_customer',   description: 'Searches for customer data' }

// Descripción que guía correctamente (casos de uso distintos y explícitos):
{
  name: 'get_customer_info',
  description: 'Retrieves full profile for a KNOWN customer. Only use when you already have the customer ID.'
}
{
  name: 'search_customer',
  description: 'Finds customers by name, email or phone. Use when you need to locate a customer but do NOT have their ID.'
}
3. Silent failures: respuestas plausibles pero incorrectas
Este es el más peligroso. El agente responde. No hay excepción. No hay error 500. Los logs están limpios. Pero la respuesta está mal.
Un agente de soporte que da instrucciones desactualizadas. Un agente de ventas que cita el precio equivocado. Un agente de análisis que saca conclusiones incorrectas porque interpretó mal una columna del dataset.
Estos fallos no los detecta ningún sistema de monitorización clásico. Los detecta el usuario. O peor: no los detecta nadie durante semanas.
Cómo construir un sistema de evals real
La solución es evaluar outputs con LLM-as-judge, complementado con métricas cuantificables:
interface EvalCase {
  input: string
  expectedBehavior: string   // descripción del comportamiento correcto
  criticalChecks: string[]   // checks binarios (pasa/no pasa)
}

async function runEval(agent: Agent, testCase: EvalCase) {
  const response = await agent.run(testCase.input)

  // 1. Checks deterministas — rápidos y baratos
  const passedCritical = testCase.criticalChecks.every(check =>
    evaluateCritical(response, check)
  )

  // 2. Evaluación cualitativa con LLM como juez
  const qualityScore = await llmJudge({
    response: response.output,
    expectedBehavior: testCase.expectedBehavior,
    rubric: 'rate 1-5: accuracy, appropriate tool use, no hallucinations'
  })

  return { passed: passedCritical, quality: qualityScore }
}
Esto no es perfecto (el juez también puede alucinar), pero detecta el 80% de los fallos silenciosos que los tests clásicos pasan por alto.
Lo que necesitas para empezar:
- Un dataset de eval con 20-50 casos reales de tu dominio — no inventados en local, sino basados en interacciones reales o diseñados por alguien que conoce el negocio en profundidad
- Métricas cuantificables por caso: qué herramienta debería usarse, si la respuesta debería tener cierto formato, cuándo redirigir a un humano
- Un eval runner que corra automáticamente en cada deploy
- Un umbral mínimo de calidad que bloquee el deploy si el agente baja del baseline
La deuda técnica que genera saltarte esto
He visto proyectos de agentes IA construidos en 3 semanas que luego consumen 3 meses de trabajo correctivo. El patrón es siempre el mismo:
- Se construye el agente con tests de humo básicos
- Se lanza a producción con usuarios reales
- Los fallos silenciosos se acumulan durante semanas sin que nadie lo detecte
- Alguien se queja, se investiga, se descubre que el agente ha fallado en el 15% de las interacciones
- Se intenta parchear sin entender las causas raíz
- El parche introduce nuevos fallos no previstos
Implementar evals desde el día uno no es perfeccionismo. Es lo que separa un agente que funciona en producción de un prototipo que funciona en demos.
¿Construirlo internamente o externalizar?
Construir un sistema de evals robusto desde cero lleva tiempo que muchos equipos no tienen. Puedes usar plataformas como Langfuse o Braintrust para el pipeline de observabilidad, pero alguien tiene que diseñar los casos de eval, definir las métricas y mantener el dataset actualizado cuando el agente evoluciona.
En DAILYMP entregamos los agentes con su suite de evals incluida: dataset inicial, runner, métricas de baseline y umbral de deploy. No porque sea bonito técnicamente, sino porque es la única forma honesta de garantizar que el agente funciona en producción.
Si tienes un agente corriendo sin sistema de evals, o estás a punto de lanzar uno, hablemos antes de que los usuarios lo descubran por ti.
También puedes explorar cómo abordamos otros problemas comunes de arquitectura en nuestro servicio de AI Driven Development.