Regresión de prompts en CI: detecta degradación antes del push
Cambias tres líneas del system prompt. Mejoras el tono, clarifica una instrucción, añades una restricción que hacía falta. Los tests de unidad pasan. El linter está verde. Haces merge.
Dos días después alguien del equipo te dice que el agente "ya no responde igual". Los tickets de soporte suben. El agente está produciendo outputs válidos técnicamente, pero peores funcionalmente. Y lo más doloroso: no tienes forma de saber en qué commit empezó.
Esto tiene un nombre: degradación silenciosa de prompt. Y a diferencia de un bug de código, no lanza excepciones ni falla en los tests convencionales.
Por qué los tests de unidad no son suficientes para prompts
Un test de unidad comprueba que una función devuelve un valor determinista dado un input. Los agentes IA no son deterministas. El mismo prompt puede producir outputs ligeramente distintos en cada llamada, y "ligeramente distintos" puede significar "perfectamente correcto" o "funcionalmente roto".
Los problemas más frecuentes que se escapan de los tests convencionales:
- Regresión semántica: el agente responde correctamente la pregunta literal pero pierde el tono, la estructura o el contexto que hacía útil la respuesta
- Pérdida de guardrails implícitos: una instrucción anterior que limitaba el comportamiento desaparece al reformular el prompt
- Degradación de formato: el JSON de salida sigue siendo válido pero los campos cambian ligeramente de nombre o estructura
- Drift de personalidad: en agentes con rol definido, el carácter se desvanece gradualmente con cada iteración del prompt
La raíz del problema es esta: cambias algo en lenguaje natural, y el efecto solo se puede medir ejecutando el agente. No hay compilador que lo detecte.
El patrón: golden dataset + scoring automatizado
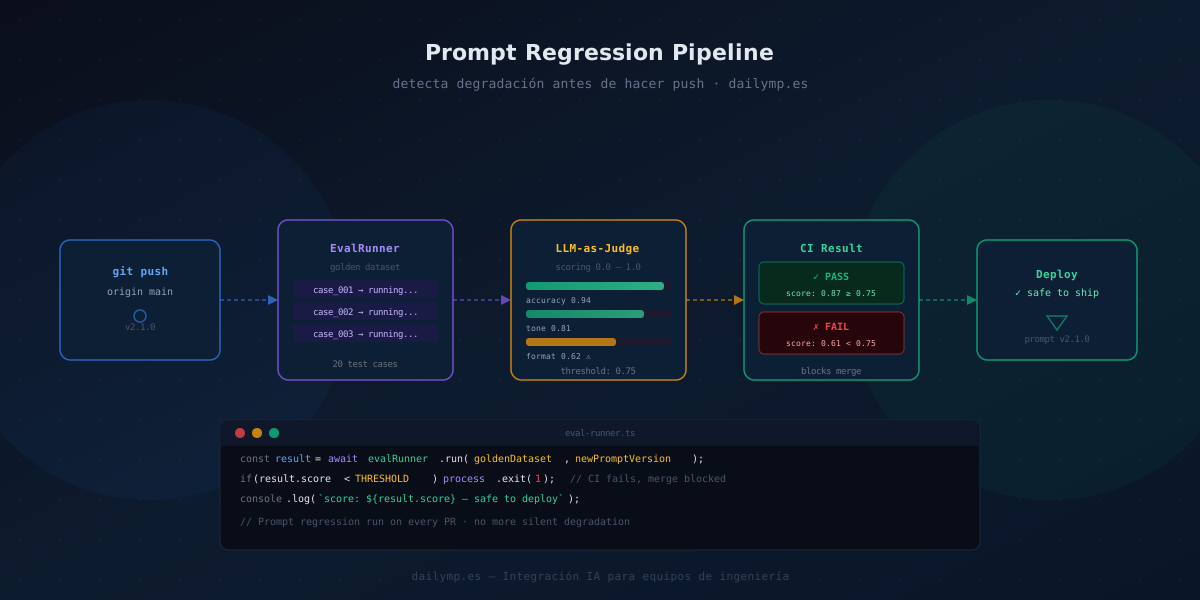
La solución es tratar los prompts como código que necesita suite de regresión. El patrón tiene tres componentes:
1. Golden dataset: un conjunto de casos de prueba con input conocido y output esperado. No tienen que ser idénticos al output real — son referencias de calidad sobre las que puntuar.
2. Eval runner: ejecuta el agente sobre cada caso del golden dataset con el nuevo prompt, recoge las respuestas.
3. Scorer automático: compara cada respuesta con la referencia y asigna una puntuación. El umbral mínimo bloquea el merge si no se alcanza.
// types/eval.ts
interface GoldenCase {
  id: string;
  input: string;
  expectedOutput: string;
  criteria: string[]; // qué dimensiones puntuar
}

interface EvalResult {
  caseId: string;
  actualOutput: string;
  score: number;       // 0.0 – 1.0
  breakdown: Record<string, number>;
  passed: boolean;
}

interface RunSummary {
  totalCases: number;
  passed: number;
  failed: number;
  avgScore: number;
  failedCases: EvalResult[];
}
LLM-as-Judge: puntuación semántica sin tests deterministas
El scorer es el componente crítico. Para outputs de lenguaje natural, la puntuación tiene que ser semántica, no sintáctica. Aquí entra el patrón LLM-as-Judge: usas otro LLM (o el mismo con un prompt diferente) para evaluar la calidad de la respuesta.
// lib/eval-runner.ts
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic();

const JUDGE_PROMPT = `
Eres un evaluador de calidad de agentes IA.
Dado un OUTPUT del agente y un OUTPUT_ESPERADO, puntúa el output en estas dimensiones:
- accuracy: ¿responde correctamente la pregunta o tarea? (0.0 – 1.0)
- format: ¿sigue el formato esperado? (0.0 – 1.0)
- tone: ¿mantiene el tono y la persona del agente? (0.0 – 1.0)

Devuelve SOLO JSON con este esquema exacto:
{ "accuracy": 0.0, "format": 0.0, "tone": 0.0, "overall": 0.0 }
`;

async function scoreCase(
  actual: string,
  expected: string,
  criteria: string[]
): Promise<{ score: number; breakdown: Record<string, number> }> {
  const response = await client.messages.create({
    model: "claude-opus-5-5",
    max_tokens: 256,
    messages: [
      {
        role: "user",
        content: `OUTPUT_ESPERADO:\n${expected}\n\nOUTPUT_ACTUAL:\n${actual}\n\nCRITERIOS A EVALUAR: ${criteria.join(", ")}`,
      },
    ],
    system: JUDGE_PROMPT,
  });

  const text =
    response.content[0].type === "text" ? response.content[0].text : "{}";
  const parsed = JSON.parse(text);

  return {
    score: parsed.overall ?? 0,
    breakdown: parsed,
  };
}

export async function runEvals(
  dataset: GoldenCase[],
  agentFn: (input: string) => Promise<string>,
  threshold = 0.75
): Promise<RunSummary> {
  const results: EvalResult[] = [];

  for (const c of dataset) {
    const actualOutput = await agentFn(c.input);
    const { score, breakdown } = await scoreCase(
      actualOutput,
      c.expectedOutput,
      c.criteria
    );

    results.push({
      caseId: c.id,
      actualOutput,
      score,
      breakdown,
      passed: score >= threshold,
    });
  }

  const passed = results.filter((r) => r.passed).length;

  return {
    totalCases: results.length,
    passed,
    failed: results.length - passed,
    avgScore: results.reduce((a, r) => a + r.score, 0) / results.length,
    failedCases: results.filter((r) => !r.passed),
  };
}
Dos notas importantes sobre este patrón:
- Usa un modelo más listo que el que evalúas cuando sea posible. Si tu agente corre en Haiku, evalúa con Sonnet. El juez debe ser más fiable que el evaluado.
- El judge prompt es código también. Tiene que ser versionado y parte del mismo pipeline de regresión.
Integrarlo en GitHub Actions
El punto crítico es que esto corre en cada PR, no solo en releases. Un cambio de prompt que pasa los tests convencionales pero baja el score de eval por debajo del umbral bloquea el merge automáticamente.
# .github/workflows/eval.yml
name: Prompt Regression Eval

on:
  pull_request:
    paths:
      - "prompts/**"
      - "lib/agent/**"

jobs:
  eval:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: Setup Node.js
        uses: actions/setup-node@v4
        with:
          node-version: "20"
          cache: "npm"

      - run: npm ci

      - name: Run prompt regression eval
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: npx tsx scripts/run-evals.ts

      - name: Upload eval report
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: eval-report
          path: eval-results.json
// scripts/run-evals.ts
import { runEvals } from "../lib/eval-runner";
import { goldenDataset } from "../tests/golden-dataset";
import { myAgent } from "../lib/agent";
import * as fs from "fs";

const THRESHOLD = 0.75;

const summary = await runEvals(goldenDataset, myAgent, THRESHOLD);

fs.writeFileSync("eval-results.json", JSON.stringify(summary, null, 2));

console.log(`\n📊 Eval summary:`);
console.log(
  `  Passed: ${summary.passed}/${summary.totalCases} (avg score: ${summary.avgScore.toFixed(2)})`
);

if (summary.failed > 0) {
  console.error(`\n❌ ${summary.failed} casos por debajo del umbral:`);
  for (const f of summary.failedCases) {
    console.error(`  ${f.caseId}: score ${f.score.toFixed(2)}`);
  }
  process.exit(1); // CI falla, merge bloqueado
}

console.log(`\n✅ Todos los casos superan el umbral. Safe to deploy.`);
El paths filter de GitHub Actions es clave: el eval solo se dispara cuando cambian los prompts o el código del agente, no en cada PR del proyecto.
Qué golden dataset necesitas (y cuántos casos)
La pregunta práctica: ¿cuántos casos hay que tener? La respuesta honesta: 20 casos bien elegidos valen más que 200 casos genéricos.
Los criterios para construir un buen golden dataset:
- Cubre los happy paths principales: los flujos que usan el 80% de los usuarios
- Incluye edge cases conocidos: entradas que históricamente han causado problemas
- Captura las regresiones anteriores: cuando detectas un bug de comportamiento, añade ese caso al dataset
- Varía el tono y la dificultad: inputs cortos, inputs largos, inputs ambiguos, inputs en otro idioma si aplica
El golden dataset crece con el tiempo. Cada bug de producción que descubres es un caso nuevo que añadir.
El coste de no tenerlo
Un cambio de prompt que degrada el comportamiento y llega a producción tiene un coste real: soporte extra, usuarios que se van, confianza del equipo en el agente que se erosiona. Lo más peligroso es que es difícil de detectar — el agente "funciona", solo funciona peor.
Un pipeline de regresión que corre en 3-5 minutos por PR y bloquea los merges problemáticos es la diferencia entre iterar con confianza y moverse con miedo a romper cosas.
Si estás construyendo agentes IA en producción y quieres implementar un sistema de evals robusto, en DAILYMP llevamos este tipo de arquitectura a equipos que ya tienen agentes en marcha. También puedes revisar cómo estructuramos los guardrails de validación de output para entender la capa que complementa este sistema.
¿Tu equipo necesita un sistema de evals para vuestros agentes? → Hablamos 30 min