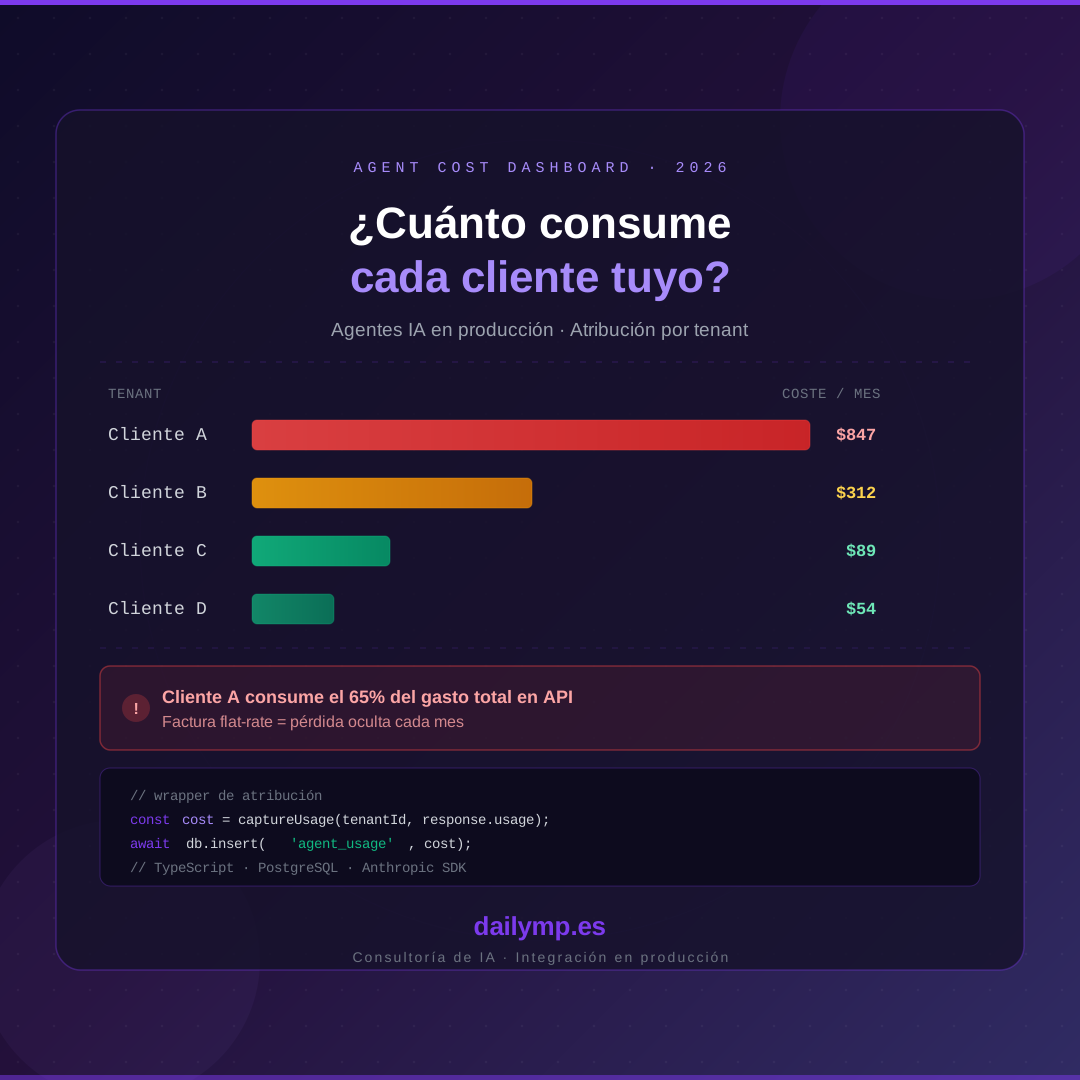
Coste por cliente en agentes IA: mide antes de cobrar
Tienes un agente IA en producción. Veinte clientes lo usan. La factura de Anthropic llega: €2.400 al mes. ¿Sabes cuánto consume cada uno?
La mayoría de equipos que me contratan para revisar su arquitectura no lo sabe. Tienen el coste total. No tienen el coste por cliente. Eso significa que cobras lo mismo a alguien que consume 200 tokens por sesión que a alguien que dispara cadenas de agentes con 15.000 tokens por operación. Estás subsidiando a tus usuarios más pesados con el margen de los que apenas usan el sistema.
Por qué el coste de un agente no es plano
Un agente IA no consume tokens de forma uniforme. Hay cuatro factores que hacen que dos sesiones del mismo agente puedan diferir en coste por un factor de 10 o 20:
- System prompt: se envía en cada llamada. Si tienes 2.000 tokens de contexto de herramientas, son 2.000 tokens de entrada en cada petición, siempre.
- Historial de conversación: crece con cada turno. Un cliente en su mensaje 20 envía 20 veces más contexto acumulado que uno nuevo.
- Tool results: cuando el agente consulta un CRM, una API externa o una base de datos, la respuesta completa se añade al contexto para el siguiente paso.
- Output del modelo: la respuesta generada, que tiene el precio más alto por token.
Sin medir por tenant estás volando a ciegas. Peor aún: estás tomando decisiones de pricing basadas en una media que nadie paga realmente.
El wrapper de atribución: medir sin tocar la lógica
La solución no requiere un servicio nuevo ni cambiar cómo usas la API de Anthropic. Consiste en envolver el cliente con una capa de medición que captura el uso de cada llamada y lo atribuye al tenant activo.
import Anthropic from "@anthropic-ai/sdk";

type TenantCost = {
  tenantId: string;
  inputTokens: number;
  outputTokens: number;
  cacheReadTokens: number;
  calls: number;
  estimatedUsd: number;
};

// Precios Claude Sonnet por millón de tokens (actualiza si cambian)
const PRICE = { input: 3.0, output: 15.0, cacheRead: 0.3 };

export class TrackedAnthropicClient {
  private client = new Anthropic();
  private ledger = new Map<string, TenantCost>();

  async messages(
    tenantId: string,
    params: Anthropic.MessageCreateParamsNonStreaming
  ) {
    const response = await this.client.messages.create(params);
    const u = response.usage;
    const cacheRead = u.cache_read_input_tokens ?? 0;
    const billableInput = u.input_tokens - cacheRead;

    const costUsd =
      (billableInput / 1_000_000) * PRICE.input +
      (cacheRead / 1_000_000) * PRICE.cacheRead +
      (u.output_tokens / 1_000_000) * PRICE.output;

    const prev = this.ledger.get(tenantId) ?? {
      tenantId,
      inputTokens: 0,
      outputTokens: 0,
      cacheReadTokens: 0,
      calls: 0,
      estimatedUsd: 0,
    };

    this.ledger.set(tenantId, {
      tenantId,
      inputTokens: prev.inputTokens + u.input_tokens,
      outputTokens: prev.outputTokens + u.output_tokens,
      cacheReadTokens: prev.cacheReadTokens + cacheRead,
      calls: prev.calls + 1,
      estimatedUsd: prev.estimatedUsd + costUsd,
    });

    return response;
  }

  getUsage(tenantId: string) {
    return this.ledger.get(tenantId);
  }
}
El ledger es en memoria. Funciona para desarrollo y para entornos con una sola instancia. En producción, necesitas persistir cada llamada.
Persistencia: registrar uso en base de datos
CREATE TABLE agent_usage (
  id                BIGSERIAL PRIMARY KEY,
  tenant_id         TEXT        NOT NULL,
  model             TEXT        NOT NULL,
  input_tokens      INTEGER     NOT NULL,
  output_tokens     INTEGER     NOT NULL,
  cache_read_tokens INTEGER     NOT NULL DEFAULT 0,
  estimated_usd     NUMERIC(10,6) NOT NULL,
  created_at        TIMESTAMPTZ NOT NULL DEFAULT NOW()
);

CREATE INDEX ON agent_usage (tenant_id, created_at);
Con esta tabla, la consulta de coste mensual por tenant es directa:
SELECT
  tenant_id,
  ROUND(SUM(estimated_usd)::numeric, 2)         AS total_usd,
  SUM(input_tokens + output_tokens)              AS total_tokens,
  COUNT(*)                                       AS total_calls
FROM agent_usage
WHERE created_at >= date_trunc('month', NOW())
GROUP BY tenant_id
ORDER BY total_usd DESC;
En dos semanas de producción esta consulta ya te dice quién es rentable y quién no.
Cuotas: frenar antes de que explote el gasto
Tener los datos es el primer paso. El segundo es actuar antes de que un cliente sobrepase su límite. Añade un check al inicio de cada llamada:
async checkAndTrack(tenantId: string, params: Anthropic.MessageCreateParamsNonStreaming) {
  const result = await db.query<{ total: string }>(
    `SELECT COALESCE(SUM(estimated_usd), 0) AS total
     FROM agent_usage
     WHERE tenant_id = $1
       AND created_at >= date_trunc('month', NOW())`,
    [tenantId]
  );

  const spent = parseFloat(result.rows[0].total);
  const limit = await getTenantSpendLimit(tenantId); // de tu tabla de planes

  if (spent >= limit) {
    throw new Error(
      `QUOTA_EXCEEDED: ${spent.toFixed(2)} / ${limit} USD este mes`
    );
  }

  return this.messages(tenantId, params);
}
El límite puede ser fijo por plan (Free: $5, Pro: $50, Enterprise: ilimitado) o dinámico basado en lo que cada cliente ha pagado ese mes. Captúralo en la misma tabla de tenants que ya tienes.
De los datos al modelo de precios
Una vez que tienes dos o tres semanas de datos reales, suelen aparecer tres grupos muy claros:
- Heavy users (20%): consumen el 60-70% del coste total. Con pricing plano, pierdes dinero con ellos cada mes sin saberlo.
- Core users (60%): uso consistente y predecible. Tu margen real.
- Light users (20%): apenas tocan el sistema. Los que sin querer financian a los heavy.
Con esta distribución puedes diseñar precios basados en uso real en lugar de intuición. Y puedes ir a los heavy users con una propuesta honesta: aquí está tu consumo real, tu plan actual no lo cubre — sin descubrirlo en la factura de fin de mes.
Los proyectos de agentes que construimos en DAILYMP siempre incluyen esta capa de medición desde el primer sprint. No como un extra: como parte de la arquitectura base de cualquier agente IA en producción. Un agente del que no sabes el coste por cliente no es un producto — es un experimento que escala en la dirección equivocada.
¿Tienes un agente en producción y no sabes cuánto consume cada cliente? Hablamos en WhatsApp y revisamos tu arquitectura juntos.