Deploya tu agente IA sin romper sesiones activas
Tienes un agente IA en producción. Llevas semanas ajustando el prompt, cambias el modelo, mejoras el system message. Lo testeas en staging: funciona perfecto. Lo subes a producción.
Tres minutos después, el soporte recibe dos tickets. Un usuario está en mitad de una conversación de onboarding y el agente le pregunta otra vez por su nombre. Otro tiene una sesión de gestión de incidencias donde el agente ha "olvidado" el contexto de los últimos cinco mensajes.
No es un bug del código. Es que acabas de reemplazar el agente mientras había usuarios dentro.
Por qué el deployment de un agente es diferente al de una web
Cuando despliegas una nueva versión de un componente React, el navegador carga el nuevo código y listo. No hay estado en vuelo que perder. Cada petición HTTP es independiente.
Un agente IA con memoria persistente no funciona así. Cada conversación activa tiene:
- Un historial de mensajes almacenado (Redis, Postgres, memoria)
- Un
system_promptque estableció el contexto inicial - Expectativas implícitas del usuario sobre el comportamiento del agente
- Herramientas registradas que el agente sabe usar
Si cambias el modelo de claude-sonnet-4-5 a claude-opus-5-5 o modificas el system_prompt entre dos mensajes de la misma sesión, el comportamiento puede cambiar de forma visible y confusa para el usuario. No necesariamente rompe la aplicación — pero rompe la coherencia de la experiencia.
Esto tiene un nombre en ingeniería de software: mid-flight state mutation. Y la solución no es "no despliegues durante horas punta". La solución es diseñar el sistema para que pueda cambiar sin afectar sesiones en curso.
Patrón 1: Session versioning (pinning)
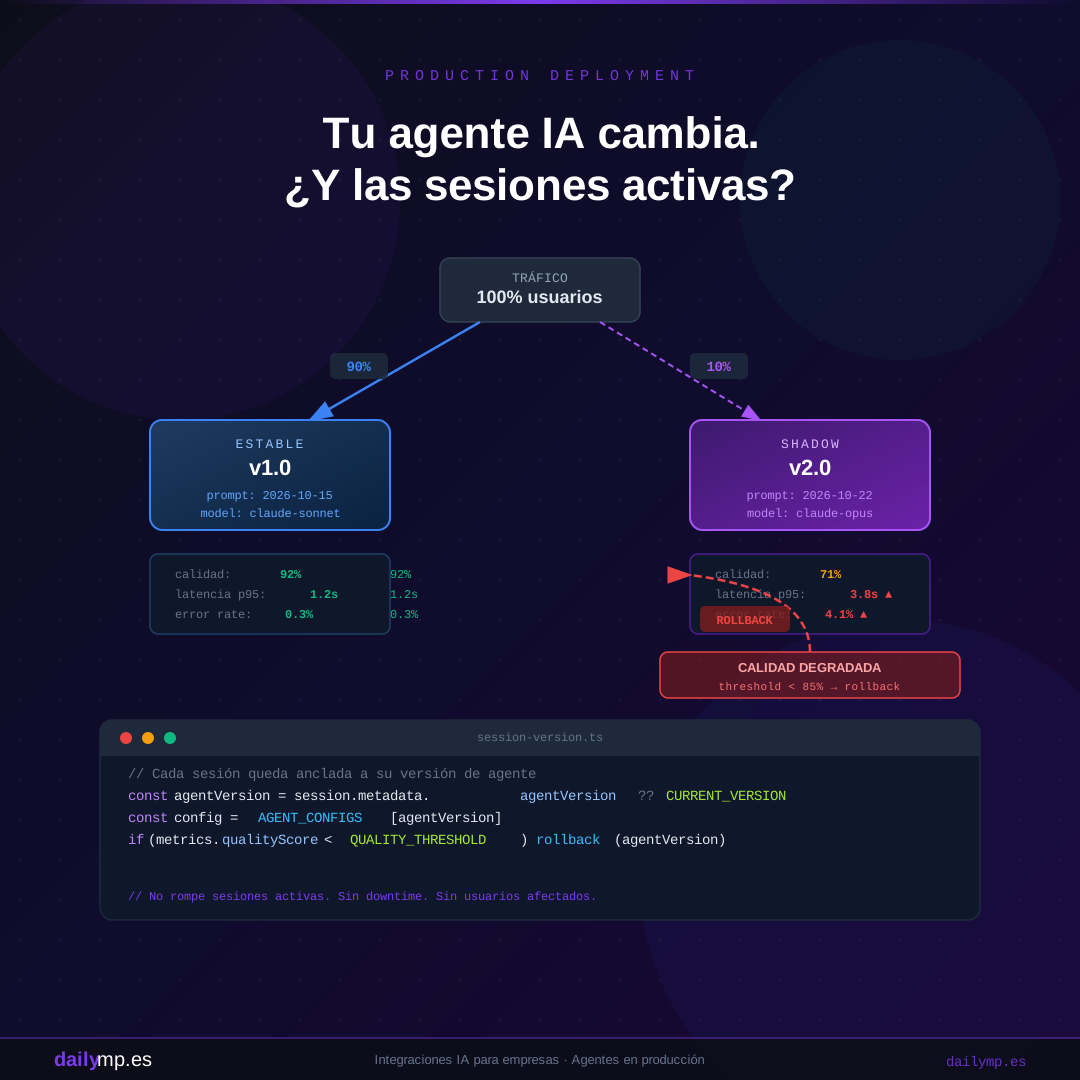
La técnica más directa. Cuando creas una sesión nueva, le asignas la versión del agente vigente en ese momento. Esa versión queda grabada en los metadatos de la sesión y no cambia aunque despliegues una nueva.
// lib/agent-config.ts
export const AGENT_CONFIGS: Record<string, AgentConfig> = {
  "v1.2": {
    model: "claude-sonnet-4-5",
    systemPrompt: PROMPTS.v1_2,
    tools: TOOLS_V1,
  },
  "v1.3": {
    model: "claude-opus-5-5",
    systemPrompt: PROMPTS.v1_3,
    tools: TOOLS_V1_3,
  },
};

export const CURRENT_VERSION = "v1.3";

// app/api/chat/route.ts
export async function POST(req: Request) {
  const { sessionId, message } = await req.json();

  const session = await getSession(sessionId);

  // Sesión existente: usa la versión con la que empezó
  const agentVersion = session?.metadata?.agentVersion ?? CURRENT_VERSION;
  const config = AGENT_CONFIGS[agentVersion];

  const response = await anthropic.messages.create({
    model: config.model,
    system: config.systemPrompt,
    messages: session.history,
    tools: config.tools,
  });

  await updateSession(sessionId, {
    history: [...session.history, { role: "assistant", content: response.content }],
    metadata: { agentVersion }, // persiste la versión
  });

  return Response.json(response);
}
Con este patrón, cada sesión nueva arranca en v1.3, pero las sesiones que empezaron en v1.2 siguen usando v1.2 hasta que el usuario las cierre. Sin downtime, sin coherencia rota.
El coste: tienes que mantener vivos los configs de versiones antiguas hasta que no queden sesiones activas que las usen. En la práctica, un TTL de 24-48h cubre el 99% de los casos.
Patrón 2: Shadow deployment con métricas de calidad
Antes de enrutar a todos los usuarios a la nueva versión, la corres en paralelo con un subconjunto pequeño y mides calidad real.
// lib/routing.ts
export function getAgentVersion(userId: string): string {
  const isInShadowGroup = hashUserId(userId) % 100 < SHADOW_PERCENTAGE;
  return isInShadowGroup ? SHADOW_VERSION : STABLE_VERSION;
}

// lib/metrics.ts
export async function trackAgentQuality(
  version: string,
  sessionId: string,
  score: number
) {
  await redis.lpush(`quality:${version}`, score);
  await redis.ltrim(`quality:${version}`, 0, 999); // últimas 1000 sesiones

  const avg = await getAverageQuality(version);
  if (avg < QUALITY_THRESHOLD) {
    await triggerRollback(version);
  }
}
La clave está en qué mides como "calidad". En un agente de soporte: tasa de resolución en primera respuesta, tiempo hasta cierre, número de re-preguntas del usuario. En un agente de onboarding: tasa de completado del flujo, mensajes hasta el siguiente paso. No uses solo latencia o tasa de error — esos indican fallos técnicos, pero un agente puede responder rápido y mal.
Patrón 3: Rollback automático con circuit breaker
El caso más crítico: despliegas en producción completa y algo va mal más rápido de lo que puedes reaccionar manualmente.
// lib/deployment.ts
const QUALITY_FLOOR = 0.85; // 85% de conversaciones sin degradación detectable
const ERROR_CEILING = 0.03; // máximo 3% de errores en tool calls

export async function checkAndRollback(version: string) {
  const [quality, errorRate] = await Promise.all([
    getAverageQuality(version),
    getErrorRate(version),
  ]);

  if (quality < QUALITY_FLOOR || errorRate > ERROR_CEILING) {
    console.error(`Rolling back ${version}: quality=${quality}, errors=${errorRate}`);
    await setCurrentVersion(PREVIOUS_STABLE_VERSION);
    await notifyTeam({ version, quality, errorRate });
  }
}

// Cron cada 5 minutos en producción
setInterval(() => checkAndRollback(CURRENT_VERSION), 5 * 60 * 1000);
El rollback no interrumpe sesiones existentes: solo cambia qué versión se asigna a las sesiones nuevas. Las sesiones en vuelo siguen en la versión que les tocó.
Lo que ningún test de staging puede detectar
Puedes tener cobertura perfecta en staging y aún así tener problemas en producción. Las conversaciones reales son más largas, más caóticas y más diversas que los test cases que escribiste.
Por eso el shadow deployment no es opcional cuando cambias el modelo o haces modificaciones profundas al system prompt. Es el único mecanismo que te da datos reales antes de comprometer el 100% del tráfico.
En DAILYMP implementamos estos patrones desde el diseño inicial, no como corrección posterior. La razón es pragmática: un agente que funciona bien pero que no se puede actualizar de forma segura no escala. Cada mejora implica riesgo, y el riesgo sin sistema de rollback es deuda técnica que se cobra en incidentes.
Si quieres ver cómo integramos esto con el servicio de agentes IA y automatización que ya usas en tu empresa, la conversación de arranque dura 30 minutos.
¿Tu agente ya está en producción y no tienes ninguno de estos sistemas? Escríbeme y lo revisamos juntos.