generateObject: extrae datos con tipo desde cualquier texto
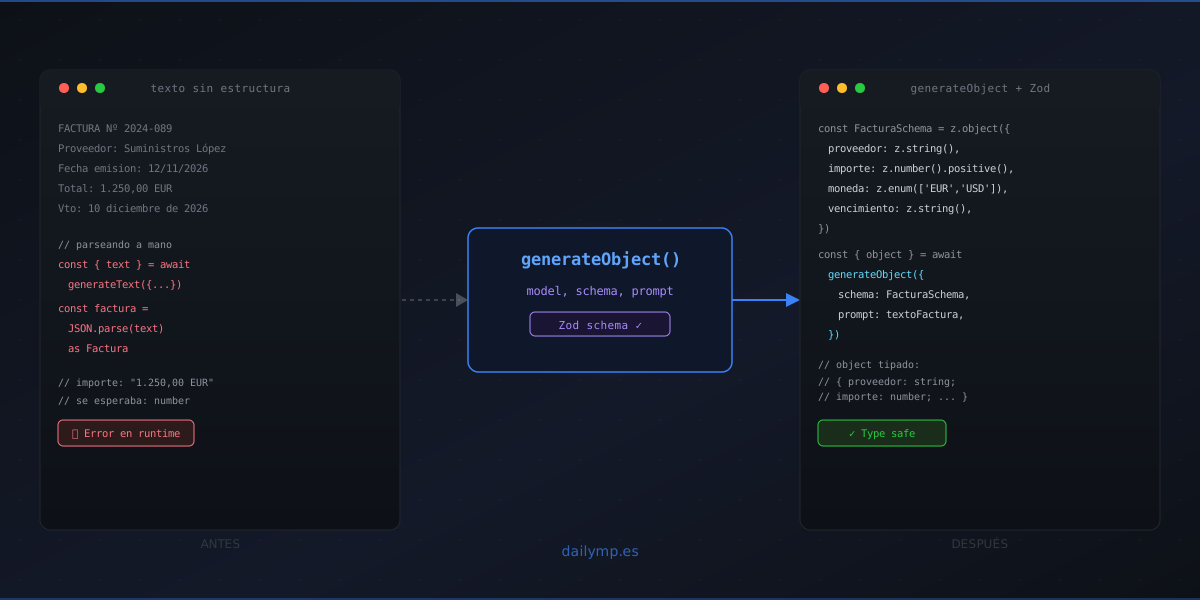
Tu agente extrae datos de una factura. Llamas a generateText, coges el texto que devuelve el modelo, haces JSON.parse() y asignas el resultado con as Factura. TypeScript te cree. Pero cuando el modelo devuelve "importe": "1.250,00 €" en lugar de "importe": 1250, el error aparece en contabilidad, no en el log de tu agente.
generateObject de Vercel AI SDK cierra esa brecha. No parseas JSON a mano: le das un schema Zod, el SDK lo convierte en un tool call internamente, valida la respuesta del modelo contra ese schema, y te devuelve el tipo inferido automáticamente.
El problema con generateText + JSON.parse
El patrón más habitual cuando un LLM tiene que devolver datos estructurados es este:
const { text } = await generateText({
  model: anthropic('claude-3-5-haiku-20241022'),
  prompt: `Extrae los datos de esta factura en JSON: ${textoFactura}`,
})

const factura = JSON.parse(text) as Factura // ← aquí empieza el problema
Tres cosas fallan aquí:
1. TypeScript te miente. El as Factura es una aserción vacía. TypeScript compila sin error aunque el objeto en runtime tenga campos de más, de menos o con tipos distintos.
2. El LLM no siempre devuelve JSON limpio. A veces añade texto antes ("Aquí tienes el JSON:") o escapa caracteres de forma incorrecta. El JSON.parse lanza una excepción no controlada.
3. No tienes validación de valores. El campo importe puede llegar como número, como string, o como string con símbolo de moneda. Tu código downstream lo descubrirá en el peor momento.
generateObject: schema primero, tipo gratis
import { generateObject } from 'ai'
import { anthropic } from '@ai-sdk/anthropic'
import { z } from 'zod'

const FacturaSchema = z.object({
  proveedor: z.string(),
  numeroFactura: z.string(),
  importe: z.number().positive(),
  moneda: z.enum(['EUR', 'USD', 'GBP']),
  fechaVencimiento: z.string().regex(/^\d{4}-\d{2}-\d{2}$/),
  lineas: z.array(z.object({
    descripcion: z.string(),
    cantidad: z.number(),
    precioUnitario: z.number(),
  })),
})

const { object } = await generateObject({
  model: anthropic('claude-3-5-haiku-20241022'),
  schema: FacturaSchema,
  prompt: `Extrae los datos de esta factura: ${textoFactura}`,
})

// object: { proveedor: string; numeroFactura: string; importe: number; ... }
// TypeScript conoce el tipo exacto sin aserciones
Lo que hace el SDK internamente:
- Convierte el schema Zod en un tool call con el JSON schema equivalente
- Envía el prompt al modelo pidiendo que llame a esa herramienta
- Valida la respuesta contra el schema de Zod
- Devuelve
result.objectcon el tipo inferido dez.infer<typeof FacturaSchema>
Si el modelo genera "importe": "1.250,00 €", la validación de Zod falla antes de que el dato llegue a tu código. No en contabilidad: en el agente.
Tres casos de uso reales
1. Clasificación automática de tickets de soporte
Cada email de cliente se lee y clasifica antes de enrutarlo:
const TicketSchema = z.object({
  categoria: z.enum(['facturación', 'técnico', 'cancelación', 'otro']),
  prioridad: z.enum(['alta', 'media', 'baja']),
  accionInmediata: z.boolean(),
  resumen: z.string().max(150),
})

const { object: ticket } = await generateObject({
  model: anthropic('claude-3-5-haiku-20241022'),
  schema: TicketSchema,
  prompt: `Clasifica este email de soporte: "${emailContent}"`,
})

if (ticket.accionInmediata) await notifyOncall(ticket)
await crm.createTicket(ticket) // ticket está completamente tipado
El equipo de soporte ya no lee cada email para decidir a quién asignarlo. El agente clasifica, el humano revisa solo los de prioridad alta.
2. Scoring de leads desde formularios de contacto
Cada contacto nuevo se puntúa antes de llegar al CRM:
const LeadSchema = z.object({
  esICP: z.boolean(),
  sector: z.string(),
  tamanoEmpresa: z.enum(['micro', 'pyme', 'mediana', 'grande']),
  urgencia: z.number().min(1).max(5),
  motivoPrincipal: z.string().max(100),
})
Este patrón forma parte del servicio de integración IA que implementamos con clientes que reciben más de 50 contactos mensuales.
3. Extracción de actas de reunión
const ActaSchema = z.object({
  participantes: z.array(z.string()),
  accionesAcordadas: z.array(z.object({
    responsable: z.string(),
    tarea: z.string(),
    fechaLimite: z.string().optional(),
  })),
  decisionesTomadas: z.array(z.string()),
})
El texto libre de una reunión se convierte en un objeto estructurado en 2-3 segundos. El gestor de tareas recibe los datos directamente, sin que nadie copie y pegue.
streamObject cuando el documento es grande
Para documentos largos o cuando quieres mostrar progreso en la UI, streamObject te da el objeto parcial en tiempo real:
import { streamObject } from 'ai'

const stream = streamObject({
  model: anthropic('claude-3-5-sonnet-20241022'),
  schema: FacturaSchema,
  prompt: `Extrae los datos: ${documentoLargo}`,
})

for await (const parcial of stream.partialObjectStream) {
  // parcial es Partial<Factura> durante la generación
  if (parcial.proveedor) mostrarProgreso(parcial.proveedor)
}

const factura = await stream.object // objeto final y completo
Los campos llegan a medida que el modelo los genera. Puedes mostrar en la UI qué campos ya se han extraído sin esperar al objeto completo. Útil cuando el documento supera las 10 páginas y el usuario espera.
Gestionar el caso en que el modelo no puede cumplir el schema
generateObject lanza NoObjectGeneratedError si el modelo no produce algo que satisfaga el schema. Esto es explícito y controlable:
import { NoObjectGeneratedError } from 'ai'

try {
  const { object } = await generateObject({
    model: anthropic('claude-3-5-haiku-20241022'),
    schema: FacturaSchema,
    prompt: `Extrae los datos: ${textoFactura}`,
  })
  return object
} catch (e) {
  if (e instanceof NoObjectGeneratedError) {
    logger.warn('generateObject falló', { rawText: e.text })
    // Reintentar con modelo más potente o escalar al humano
    return null
  }
  throw e
}
Lo que e.text contiene es el texto crudo que devolvió el modelo antes de fallar la validación. Sirve para diagnosticar si el problema es el prompt, el modelo o el schema.
mode: tool vs mode: json — cuándo usar cada uno
Por defecto el SDK usa mode: 'auto', que elige según el proveedor. Puedes sobreescribirlo:
mode: 'tool'(recomendado para schemas complejos): Envuelve el schema como una herramienta que el modelo "llama". Más fiable para schemas anidados, arrays y enums.mode: 'json': Le pide al modelo que devuelva JSON directamente. Algunos modelos añaden texto antes del JSON, lo que puede causar errores de parse.mode: 'auto': El SDK elige según el proveedor. Válido para código portable entre modelos.
Para producción con schemas complejos, usa mode: 'tool' explícitamente en lugar de confiar en auto.
Siguiente paso
Si tu equipo ya usa Vercel AI SDK y tiene agentes que extraen datos con generateText + parsing manual, migrar a generateObject suele ser un cambio de menos de una hora por agente. El beneficio en seguridad de tipos y en detección temprana de errores compensa en el primer deploy a producción.
También puedes combinar esto con validación de tool calls en producción para cubrir tanto la extracción desde documentos como la ejecución de herramientas externas.
Si quieres añadir extracción de documentos estructurados a tu flujo de trabajo — facturas, contratos, emails de clientes — puedo ayudarte a diseñar el schema y el pipeline completo.