Errores en tools de agentes IA: recuperación real
Tu agente funciona perfecto en staging. Supera todos los tests. Lo despliegas en producción, y la primera vez que el servicio externo tarda un poco más de lo normal, el agente para en seco. Sin mensaje de error útil. Sin posibilidad de recuperación. El usuario ve un spinner infinito o un "algo salió mal" genérico.
Este es el fallo más común que veo en agentes IA en producción, y la causa casi siempre es la misma: las tools lanzan excepciones en vez de devolver resultados estructurados.
Por qué las excepciones no llegan al LLM
Para entender el problema hay que tener claro cómo funciona el protocolo de tool calling. El LLM envía un mensaje tool_use con el nombre de la función y sus parámetros. Tu código ejecuta la función. El resultado vuelve al LLM como un mensaje tool_result. El LLM lo lee como contexto y decide qué hacer a continuación.
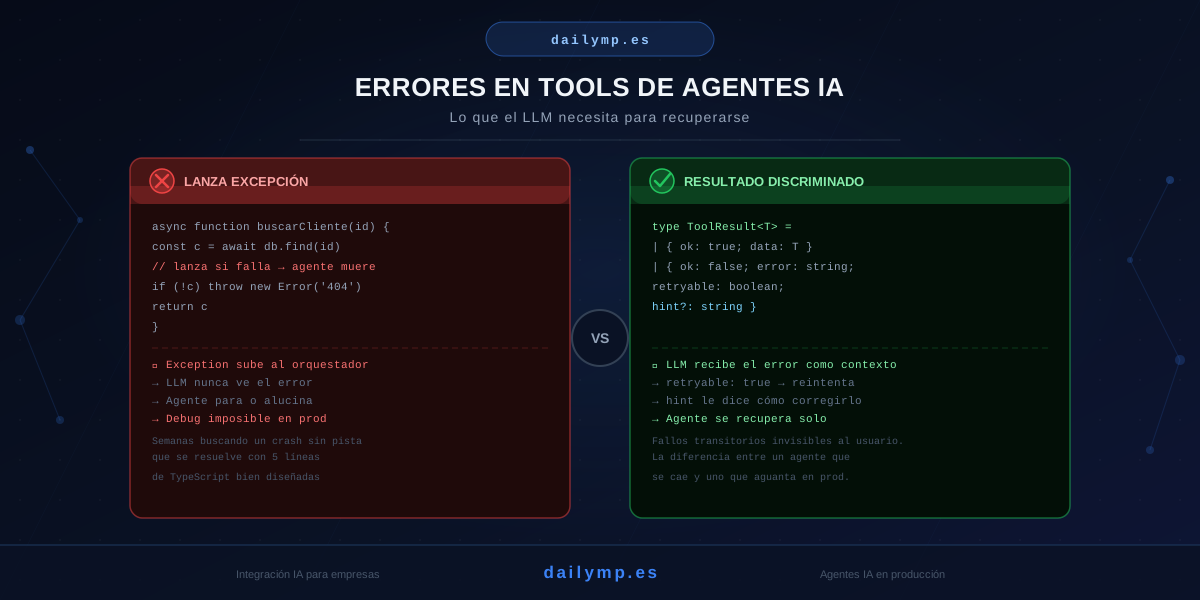
El problema: si tu función lanza una excepción, esa excepción no se convierte en un tool_result. Sube por el call stack hasta el orquestador, que la captura y para la ejecución del agente. El LLM nunca sabe qué pasó. No tiene información para decidir si reintentar, pedir datos distintos al usuario, o usar un camino alternativo.
La excepción no viaja de vuelta al LLM. Se queda en tu capa de infraestructura, inútil como contexto para el modelo.
El antipatrón que todos usamos al principio
// Tool que revienta el agente cuando falla la DB o el ID no existe
async function buscarClienteTool({ id }: { id: string }) {
  const cliente = await db.clientes.findById(id) // lanza si la DB falla
  if (!cliente) throw new Error(`Cliente ${id} no encontrado`)
  return cliente
}
Este código parece correcto. Tiene manejo de errores. El problema es que esos errores no van a ningún sitio útil: el LLM no los ve. El agente muere en silencio o devuelve una respuesta vaga que no ayuda a nadie.
El patrón correcto: resultado discriminado con hint de recuperación
La solución es devolver el error como parte del resultado de la tool, con suficiente información para que el LLM pueda actuar:
type ToolOk<T> = { ok: true; data: T }
type ToolErr = {
  ok: false
  error: string
  retryable: boolean
  hint?: string
}
export type ToolResult<T> = ToolOk<T> | ToolErr

async function buscarClienteTool(
  { id }: { id: string }
): Promise<ToolResult<Cliente>> {
  try {
    const cliente = await db.clientes.findById(id)
    if (!cliente) {
      return {
        ok: false,
        error: `Cliente ${id} no existe en la base de datos`,
        retryable: false,
        hint: 'Verifica el ID con el usuario antes de llamar a esta tool'
      }
    }
    return { ok: true, data: cliente }
  } catch (err) {
    return {
      ok: false,
      error: 'Base de datos temporalmente no disponible',
      retryable: true,
      hint: 'Reintenta en 5 segundos con exactamente los mismos parámetros'
    }
  }
}
Lo que el LLM hace con cada tipo de respuesta
retryable: false + hint sobre el ID: el LLM pregunta al usuario por el identificador correcto. No reintenta la misma llamada que sabe que va a fallar.
retryable: true + hint de timeout: el LLM reintenta la tool (si tiene un mecanismo de retry configurado) o informa al usuario de que hay un problema temporal y lo volverá a intentar.
{ error: "Database error 500" } sin más: el LLM adivina. Puede reintentar cuando no tiene sentido, o parar cuando podría recuperarse. Los resultados son impredecibles.
El campo hint no es cosmético. Es el mensaje que el LLM usa para decidir su siguiente acción. Cuanto más específico, mejor el comportamiento en producción.
Cómo exponer este tipo en el sistema prompt
Para que el modelo sepa interpretar estos resultados, una sola línea en el system prompt es suficiente:
When a tool returns { ok: false, retryable: true }, retry once after a brief pause.
When retryable is false, do not retry—instead, ask the user for clarification based on the hint field.
No hace falta construir lógica de orquestación compleja. El LLM lo gestiona como contexto.
El paso que nadie da: testear los caminos de error
La mayoría de equipos testean el happy path. El LLM llama a la tool, la tool devuelve datos, el agente responde. Pero los caminos de error son los que rompen producción.
Este es el test que deberías tener para cada tool crítica:
it('reintenta cuando la tool devuelve retryable: true', async () => {
  buscarClienteMock
    .mockResolvedValueOnce({
      ok: false,
      retryable: true,
      error: 'BD no disponible',
      hint: 'Reintenta en 5 segundos'
    })
    .mockResolvedValueOnce({ ok: true, data: clienteEjemplo })

  const resultado = await ejecutarAgente('Busca el cliente con ID abc123')

  expect(buscarClienteMock).toHaveBeenCalledTimes(2)
  expect(resultado).toContain(clienteEjemplo.nombre)
})

it('no reintenta cuando retryable es false', async () => {
  buscarClienteMock.mockResolvedValueOnce({
    ok: false,
    retryable: false,
    error: 'Cliente abc999 no existe',
    hint: 'Verifica el ID con el usuario'
  })

  const resultado = await ejecutarAgente('Busca el cliente con ID abc999')

  expect(buscarClienteMock).toHaveBeenCalledTimes(1)
  expect(resultado).toContain('verifica') // el LLM pide confirmación
})
Estos tests cuestan diez minutos de escribir y evitan semanas de debugging en producción.
Resultados reales
Los equipos que implementan este patrón consiguen agentes que se recuperan solos de fallos transitorios —timeouts de BD, rate limits de APIs externas, respuestas malformadas— sin intervención manual y sin que el usuario lo note.
Los que no lo implementan dedican horas a depurar crashes en producción que no dejan rastro en logs, porque la excepción nunca llegó a donde debería haber llegado.
La diferencia entre los dos es exactamente este tipo: ToolResult<T>. Cinco líneas de TypeScript que separan un agente frágil de uno que aguanta en producción.
Siguiente paso
Si estás construyendo un agente y tienes tools que lanzan excepciones, este es el primer sitio donde miramos cuando algo falla en producción. Es el cambio más barato que puedes hacer con el mayor impacto en estabilidad.
En DAILYMP construimos agentes con arquitecturas que no se rompen en producción: desde el diseño de las tools hasta los tests de recuperación, los mecanismos de observabilidad y los patrones de retry que el LLM entiende.
Si tu agente falla en producción y no sabes por qué, probablemente es esto. Si quieres revisarlo juntos, en 30 minutos te digo exactamente dónde está el problema y cómo lo arreglamos.
Revisar la arquitectura de mi agente →
¿Ya tienes el patrón implementado pero tu agente sigue fallando? Lee cómo funcionan las cadenas de fallback entre agentes para los casos en que la tool en sí no puede recuperarse.