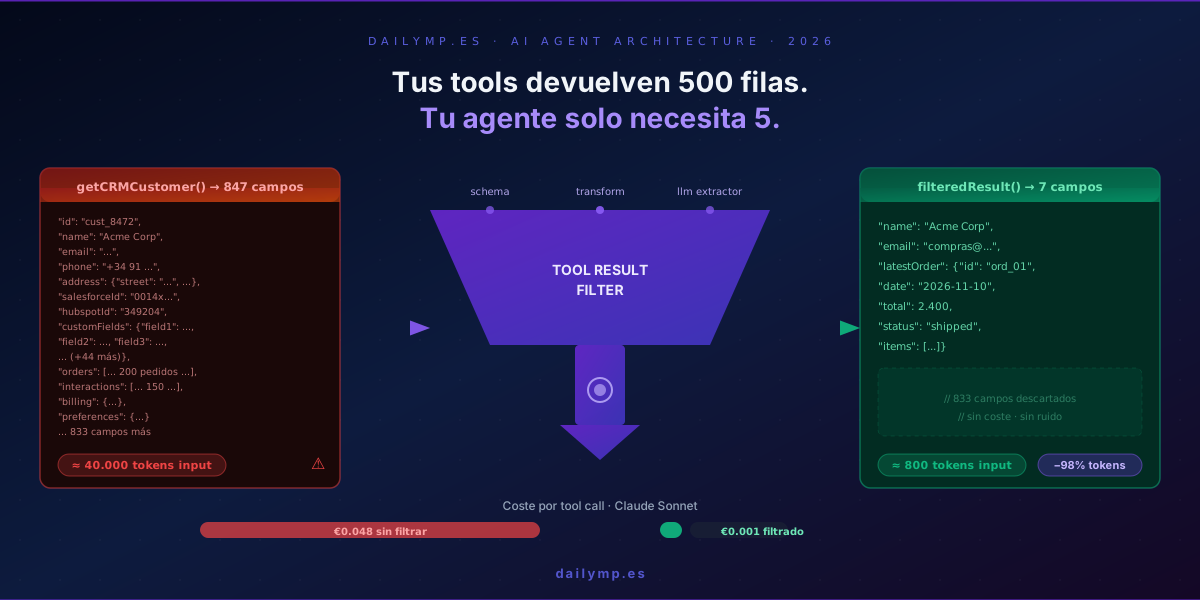
Tus tools devuelven 500 filas. Tu agente necesita 5.
He revisado el tercer agente en producción en dos semanas con exactamente el mismo problema: un tool call que devuelve 40.000 tokens de datos cuando el agente necesita 300.
No es un fallo del modelo. No es un fallo del framework. Es un fallo de arquitectura que nadie menciona porque no explota de golpe — se va comiendo el presupuesto en silencio, semana tras semana.
El contexto contaminado que nadie mide
Escenario real: un agente de atención al cliente necesita consultar el historial de un cliente para responder sobre su último pedido.
El tool getCRMCustomer llama a la API del CRM y devuelve el objeto completo:
{
  "id": "cust_8472",
  "name": "Acme Corp",
  "email": "compras@acmecorp.com",
  "phone": "+34 91 123 4567",
  "address": { "street": "...", "city": "...", "country": "..." },
  "created_at": "2021-03-14T...",
  "salesforceId": "0014x00000AB7Cd",
  "hubspotId": "349204",
  "customFields": { ... },
  "orders": [ ... ],
  "interactions": [ ... ],
  "billing": { ... }
  // ... 847 campos en total
}
El agente recibe ese bloque entero en el tool result. Procesa todos esos tokens. Responde sobre el último pedido.
Para esa respuesta, necesitaba:
nameemailorders[0]— el más reciente
Tres campos. Enviaste 847. El ratio de señal sobre ruido es del 0,35%.
Por qué esto destroza tu agente en cuatro formas
1. Coste desproporcionado
Con Claude Sonnet, procesar 40.000 tokens de input cuesta aproximadamente €0,048 por consulta. Con 1.000 consultas al día son €1.440 al mes — solo en tokens de un tool call que podría costar €0,001 con filtrado correcto.
La caché semántica ayuda con consultas repetidas. Pero no resuelve las consultas únicas donde el contexto se infla igual.
2. Degradación de la calidad de respuesta
Los modelos de lenguaje tienen lo que se llama "dilución de atención": cuanto más texto irrelevante hay en el contexto, más difícil es localizar y usar la información relevante.
No es teórico. En un experimento interno con un agente de clasificación de incidencias, reducir el contexto de 12.000 a 1.400 tokens mejoró la precisión del 71% al 89%. Mismo modelo, misma tarea, menos ruido.
3. Overflow prematuro del contexto
Si el agente hace varios tool calls por conversación, cada respuesta inflada acorta cuánto aguanta la conversación antes de necesitar summarización. Un contexto que debería aguantar 20 turnos aguanta 6.
4. Latencia innecesaria
Más tokens de input significa más tiempo de procesamiento. En agentes orientados al usuario donde la latencia importa, esto suma en cada interacción.
Tres patrones para filtrar antes de que el LLM vea el resultado
Patrón 1: Proyección de schema (la más eficiente)
Si controlas el tool, filtra en la consulta, no después.
// ❌ Devuelve todo
const getCRMCustomer = tool({
  description: 'Get customer from CRM',
  parameters: z.object({ customerId: z.string() }),
  execute: async ({ customerId }) => {
    return await crmClient.customers.get(customerId);
  }
});

// ✅ Solo los campos que el agente necesita
const getCRMCustomer = tool({
  description: 'Get customer name, email and latest order',
  parameters: z.object({ customerId: z.string() }),
  execute: async ({ customerId }) => {
    const customer = await crmClient.customers.get(customerId, {
      fields: ['name', 'email', 'orders'],
      ordersLimit: 1,
      ordersFields: ['id', 'date', 'total', 'status', 'items'],
    });
    return {
      name: customer.name,
      email: customer.email,
      latestOrder: customer.orders[0] ?? null,
    };
  }
});
De 847 campos a 7. Sin procesamiento extra, sin coste adicional. El tool devuelve exactamente lo que el agente necesita razonar.
Cuándo usarlo: siempre que controles la implementación del tool.
Patrón 2: Interceptor de transform (cuando no controlas el tool)
Cuando el tool viene de una librería externa o un MCP server que no puedes modificar, añades una capa de transformación entre la ejecución y el retorno al LLM:
const createFilteredTool = <TParams extends z.ZodType>(
  baseTool: ReturnType<typeof tool<TParams>>,
  transform: (result: unknown) => unknown
) => ({
  ...baseTool,
  execute: async (params: z.infer<TParams>, options: ToolExecutionOptions) => {
    const rawResult = await baseTool.execute(params, options);
    return transform(rawResult);
  }
});

// Uso con un tool externo
const filteredCustomerTool = createFilteredTool(
  externalCrmTool,
  (raw: CRMResponse) => ({
    name: raw.customer.name,
    email: raw.customer.contacts.email,
    latestOrder: raw.customer.orderHistory.slice(0, 1).map(o => ({
      id: o.orderId,
      date: o.createdAt,
      total: o.totalAmount,
      status: o.fulfillmentStatus,
    }))[0] ?? null,
  })
);
La arquitectura del agente no cambia. El LLM ve siempre el resultado transformado. El interceptor vive fuera del tool original — puedes actualizarlo sin tocar la dependencia externa.
Cuándo usarlo: tools de terceros, MCP servers externos, APIs legacy.
Patrón 3: Extractor LLM ligero (para contenido no estructurado)
Cuando el tool devuelve texto libre — una página web, un email, un PDF procesado — no puedes aplicar proyección de campos. Usas un modelo pequeño y barato como extractor:
import { generateText } from 'ai';
import { anthropic } from '@ai-sdk/anthropic';

const extractRelevantContent = async (
  rawContent: string,
  relevantFor: string,
  maxTokens = 400
): Promise<string> => {
  const { text } = await generateText({
    model: anthropic('claude-haiku-4-5'),
    system: [
      'Extract only the information directly relevant to the query.',
      'Be concise. Discard metadata, navigation, ads, and boilerplate.',
      'If nothing is relevant, return: "No relevant information found."',
    ].join(' '),
    prompt: `Query: ${relevantFor}\n\nContent:\n${rawContent}`,
    maxTokens,
  });
  return text;
};

// En la definición del tool
const webSearchTool = tool({
  description: 'Search the web for information',
  parameters: z.object({
    query: z.string(),
    relevantFor: z.string().describe('What specific information is needed'),
  }),
  execute: async ({ query, relevantFor }) => {
    const rawHtml = await searchAndFetch(query);
    return await extractRelevantContent(rawHtml, relevantFor);
  }
});
El coste de un call a Haiku para extraer de 20.000 tokens a 400 es ~€0,003. Si el tool result pasa de 20.000 a 400 tokens en el contexto del agente principal con Sonnet, el ahorro por consulta es de €0,023. Con 500 consultas al día: €11,50 de ahorro diario.
Cuándo usarlo: web scraping, procesamiento de emails, documentos, cualquier contenido textual no estructurado.
Cuándo usar cada patrón
| Situación | Patrón recomendado |
|---|---|
| Controlo el código del tool | Proyección de schema |
| Tool externo / MCP server | Interceptor de transform |
| Resultado es texto libre / HTML | Extractor LLM ligero |
| Tool devuelve array grande | Proyección + paginación |
| Resultado mixto (struct + texto) | Transform + Extractor combinados |
Dónde encaja esto en tu arquitectura
Este patrón no reemplaza el manejo de context overflow ni la caché semántica. Es una capa previa: evita que el contexto se infle antes de llegar a esos problemas.
La secuencia correcta en un agente de producción:
- Proyección de schema en el tool → solo los campos necesarios llegan al resultado
- Interceptor de transform si el tool es externo → normaliza el formato
- Extractor LLM si el contenido es texto libre → comprime sin perder señal
- Caché semántica para reutilizar resultados entre usuarios
- Summarización de contexto si la conversación se alarga
El error más común es llegar al paso 5 sin haber implementado el 1 y el 2. Es como poner aire acondicionado en una habitación con todas las ventanas abiertas.
El diagnóstico es simple
Si tienes agentes en producción y no has auditado el tamaño de tus tool results, es probable que estés pagando entre 3 y 10 veces más de lo necesario.
La auditoría cuesta 24 horas: loggea el número de tokens de cada tool result durante un día. Si alguno supera los 2.000 tokens de media, tienes un candidato inmediato para aplicar estos patrones.
Si quieres que lo revisemos juntos y veamos qué parte de tu arquitectura tiene más impacto para optimizar, en 30 minutos te digo exactamente qué cambiaría.