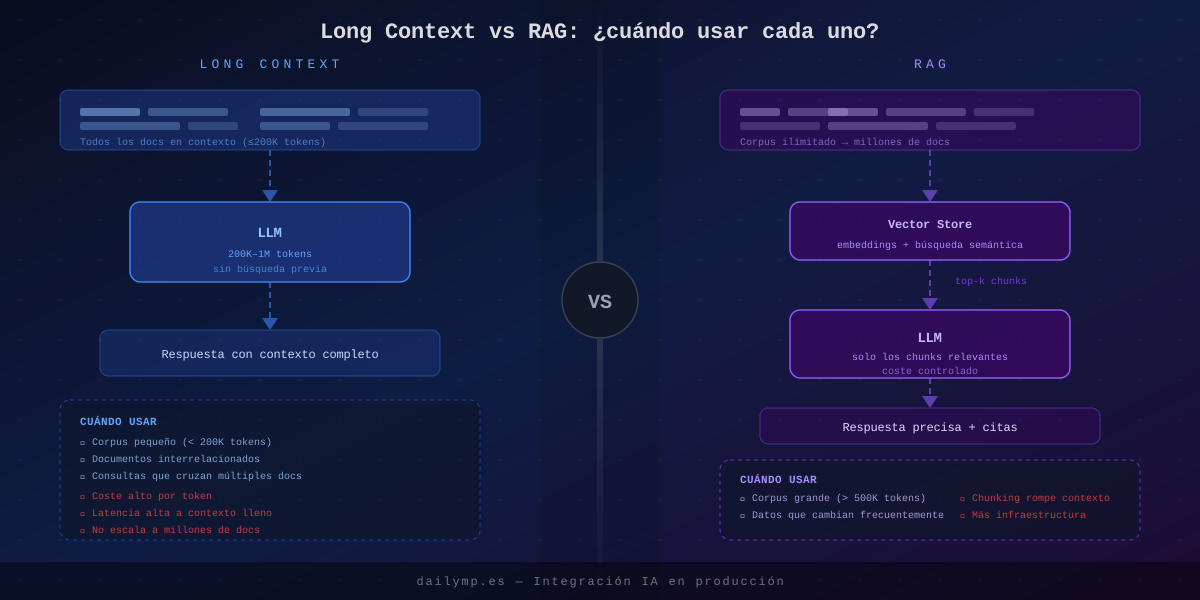
Long context vs RAG: cuándo usar cada uno en 2026
Construiste el RAG porque el contexto era corto. Ahora tienes modelos con 200.000 tokens — algunos con un millón. ¿Sigues necesitando el pipeline de embeddings, el vector store y el paso de retrieval?
La respuesta honesta: a veces sí, a veces no. Y elegir mal no es neutro. Un RAG innecesario añade latencia, coste de infraestructura y un punto de fallo extra. Un long-context mal calibrado te cobra en tokens lo que podrías recuperar con diez líneas de código.
Esta guía es el criterio de decisión que aplicamos cuando auditamos arquitecturas de agentes en producción.
Por qué la pregunta importa más ahora
Hasta 2024 la decisión era fácil: los modelos tenían 4.000 u 8.000 tokens de contexto. Meter una base de conocimiento era imposible. RAG era la única opción.
En 2026 la situación cambió:
- Claude 3.x y 4.x: 200K tokens de contexto
- GPT-4o y Gemini Pro: 128K–1M tokens
- Modelos open-source: Llama 3.1 con 128K
La consecuencia práctica es que muchos sistemas que hoy tienen RAG podrían simplificarse enormemente si el corpus cabe en contexto. Pero "cabe" no es el único criterio.
El árbol de decisión que usamos
Antes de escribir código, haz estas cuatro preguntas en orden:
1. ¿Cuánto pesa el corpus completo en tokens?
Si cabe en el contexto del modelo con margen (deja al menos un 30% libre para la respuesta y el historial de conversación), long context es la primera opción a evaluar.
Regla práctica: un PDF de 50 páginas son aproximadamente 20.000 tokens. 200 páginas de documentación técnica están alrededor de los 80.000 tokens. Una base de conocimiento de empresa mediana suele moverse entre 50.000 y 500.000 tokens.
2. ¿Con qué frecuencia cambian los datos?
Si los documentos se actualizan en tiempo real (precios, stock, contratos activos), long context requiere reconstruir el contexto en cada request. RAG permite indexar incrementalmente solo lo que cambia.
3. ¿Cuántas consultas simultáneas esperas?
Un contexto de 200K tokens cuesta más que uno de 4K. A 100 requests/hora el coste es asumible. A 10.000 requests/hora el coste de long context puede ser diez veces el de RAG, porque RAG solo mete en contexto los chunks relevantes.
4. ¿Las consultas cruzan información de varios documentos a la vez?
Este es el punto donde long context gana claramente. La búsqueda semántica de RAG recupera chunks aislados. Cuando la respuesta correcta requiere conectar datos de tres documentos diferentes, el modelo con contexto completo lo hace mejor que el que recibió tres fragmentos desconectados.
Long context: cuándo es la respuesta correcta
Long context gana cuando:
- Corpus pequeño y estable: manuales de producto, SLAs, documentación interna que no cambia cada semana. Lo cargas una vez en contexto y listo.
- Consultas que requieren visión global: "¿En qué contratos tenemos cláusula de penalización por retraso?" requiere leer todos los contratos, no recuperar uno.
- Equipos sin infraestructura de datos: si no tienes un vector store montado ni tiempo para mantenerlo, long context es un pipeline de cero piezas.
- Prototipos y MVPs: montar RAG tarda días. Long context tarda minutos.
import Anthropic from "@anthropic-ai/sdk";
import { readFileSync } from "fs";

const client = new Anthropic();

async function queryWithLongContext(
  corpusFiles: string[],
  question: string
): Promise<string> {
  // Cargamos todos los documentos en un único bloque de contexto
  const corpus = corpusFiles
    .map((f) => {
      const content = readFileSync(f, "utf-8");
      return `<document source="${f}">\n${content}\n</document>`;
    })
    .join("\n\n");

  const response = await client.messages.create({
    model: "claude-opus-5-5",
    max_tokens: 4096,
    system: `Eres un asistente especializado. Responde SOLO con información presente en los documentos proporcionados. Si la información no está, dilo explícitamente.`,
    messages: [
      {
        role: "user",
        content: `${corpus}\n\n---\n\nPregunta: ${question}`,
      },
    ],
  });

  return response.content[0].type === "text" ? response.content[0].text : "";
}
RAG: cuándo sigue siendo necesario
RAG es la respuesta correcta cuando:
- Corpus grande: más de 300.000-500.000 tokens. A partir de ahí el coste de long context por consulta empieza a ser prohibitivo.
- Datos que cambian con frecuencia: nuevos clientes, contratos que se firman cada semana, catálogos de producto que se actualizan. Indexar incremental es mucho más barato que reconstruir el contexto completo.
- Volumen alto de consultas: si tienes cientos de usuarios consultando en paralelo, RAG reduce drásticamente el coste por consulta al meter solo los chunks relevantes.
- Necesitas citar la fuente exacta: RAG recupera chunks con metadatos de origen. Es fácil devolver "según el contrato X, cláusula 4.2…". Con long context puedes pedir al modelo que cite, pero la precisión es menor.
El error más común que vemos en auditorías: equipos que montan RAG para 50 documentos internos que raramente cambian. Están pagando por infraestructura que no necesitan.
Puedes ver los errores de chunking que rompen silenciosamente los RAG en producción en el artículo sobre pipelines RAG que fallan en producción.
El patrón híbrido: lo mejor de los dos mundos
Para corpus medianos (100K-2M tokens) con consultas que requieren cruces entre documentos, el patrón que mejor funciona en producción es el híbrido:
- RAG recupera los K documentos más relevantes (no chunks, documentos completos o secciones largas)
- Esos documentos se meten en contexto completo para la generación
import Anthropic from "@anthropic-ai/sdk";

interface Document {
  id: string;
  content: string;
  score: number;
}

async function hybridQuery(
  vectorStore: { search: (q: string, k: number) => Promise<Document[]> },
  question: string,
  topK = 5
): Promise<string> {
  const client = new Anthropic();

  // Paso 1: RAG recupera los documentos más relevantes
  const relevantDocs = await vectorStore.search(question, topK);

  // Paso 2: los documentos completos van en contexto (no solo los chunks)
  const context = relevantDocs
    .map((doc) => `<doc id="${doc.id}" relevance="${doc.score.toFixed(2)}">\n${doc.content}\n</doc>`)
    .join("\n\n");

  // Paso 3: generación con contexto rico
  const response = await client.messages.create({
    model: "claude-sonnet-5-5",
    max_tokens: 2048,
    messages: [
      {
        role: "user",
        content: `Documentos relevantes:\n\n${context}\n\n---\n\nPregunta: ${question}\n\nResponde basándote SOLO en los documentos anteriores. Cita el id del documento cuando uses información de él.`,
      },
    ],
  });

  return response.content[0].type === "text" ? response.content[0].text : "";
}
Este patrón evita los problemas de chunking mal hecho (el documento llega completo) y controla el coste (solo los documentos relevantes entran en contexto).
El error de arquitectura más frecuente
El problema que encontramos con más frecuencia: usar RAG por inercia. El equipo monta el vector store porque "así se hace", sin medir si el corpus cabe en contexto.
El segundo error más frecuente: usar long context sin control de costes. Meter 180.000 tokens en cada petición de un chatbot que recibe 5.000 consultas diarias puede costar diez veces más de lo presupuestado.
La decisión correcta requiere medir primero: tamaño real del corpus, frecuencia de actualización, volumen de consultas y presupuesto por respuesta. A partir de ahí, la arquitectura sale sola.
Si estás construyendo un agente que necesita acceder a documentación interna y no sabes qué patrón usar, en DAILYMP hacemos la auditoría de arquitectura antes de escribir código.
Conclusión: no hay una respuesta universal
Long context no mató a RAG. RAG no es siempre la respuesta "seria". La arquitectura correcta depende del tamaño del corpus, la frecuencia de actualización, el volumen de consultas y el presupuesto.
Lo que sí es universal: elegir sin medir sale caro. El coste de tres horas de análisis es siempre menor que el de desmontar una arquitectura equivocada tres meses después.
¿Estás construyendo un sistema de consulta documental y no tienes claro qué patrón usar? Cuéntame el caso — hablamos por WhatsApp y en 30 minutos te digo qué tiene más sentido para tu caso.