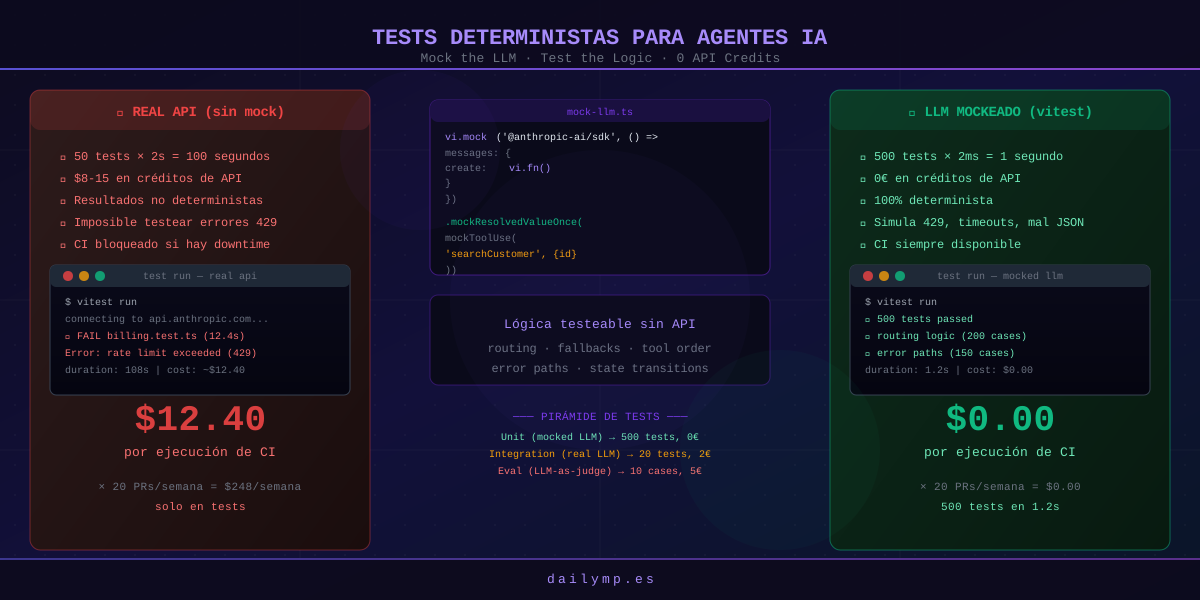
Mockea el LLM en tus tests: 500 casos, 0 créditos de API
Tu factura de Anthropic de este mes tiene una línea rara: $47 en llamadas de CI. No es el agente en producción. Son los tests.
Tienes 50 tests que llaman a la API real de Claude. Cada ejecución tarda 2 minutos y gasta créditos. Cuando GitHub Actions lanza tres runs simultáneos porque dos PRs se abrieron a la vez, la factura se multiplica. Y para colmo, uno de esos tests falla aleatoriamente porque el LLM devolvió el JSON un poco diferente esta vez.
Este es el problema de testear agentes IA contra la API real. No es un problema de dinero únicamente — es que los tests que dependen de un LLM en vivo no son fiables como suite de regresión.
La confusión habitual: qué mockear y qué no
La arquitectura de tests para agentes tiene tres capas con propósitos distintos, y confundirlas es el origen de todo el problema.
Tests unitarios (LLM mockeado): validan la lógica del agente — routing, manejo de errores, orden de tool calls, transiciones de estado. No tocan la API real. 500 tests en 1 segundo, 0€.
Tests de integración (LLM real, tools mockeadas): validan que tus prompts funcionan como esperas. Aquí sí conviene llamar al LLM, pero con el patrón de dependency injection para controlar las herramientas externas. 20–30 tests, se ejecutan en staging, coste mínimo.
Evaluaciones (LLM-as-judge): validan la calidad del output. Estos sí necesitan LLM real evaluando LLM real. Los cubrimos en el artículo de regresión de prompts en CI.
El error más común es mezclar la capa 1 con la capa 3: usar la API real para testear lógica que se podría comprobar con un mock determinista.
Cómo mockear el cliente de Anthropic en Vitest
El cliente de @anthropic-ai/sdk es una clase ordinaria. Con vi.mock la sustituyes por una versión controlada:
// tests/helpers/mock-llm.ts
import { vi } from 'vitest'
import type Anthropic from '@anthropic-ai/sdk'

vi.mock('@anthropic-ai/sdk', () => ({
  default: vi.fn().mockImplementation(() => ({
    messages: {
      create: vi.fn(),
    },
  })),
}))

// Factory: respuesta de texto simple
export function mockTextResponse(text: string): Anthropic.Message {
  return {
    id: 'mock-id',
    type: 'message',
    role: 'assistant',
    content: [{ type: 'text', text }],
    model: 'claude-sonnet-4-5',
    stop_reason: 'end_turn',
    usage: { input_tokens: 100, output_tokens: 50 },
  }
}

// Factory: respuesta con tool use
export function mockToolUse(
  toolName: string,
  input: Record<string, unknown>
): Anthropic.Message {
  return {
    id: 'mock-id',
    type: 'message',
    role: 'assistant',
    content: [{ type: 'tool_use', id: 'mock-tool-id', name: toolName, input }],
    model: 'claude-sonnet-4-5',
    stop_reason: 'tool_use',
    usage: { input_tokens: 150, output_tokens: 80 },
  }
}
Con estas dos factories puedes simular cualquier secuencia de respuestas que devolvería el LLM.
Testear la lógica de routing
El test más valioso que puedes escribir con un mock: verificar que el agente llama las tools en el orden correcto.
// tests/billing-agent.test.ts
import { describe, it, expect, beforeEach } from 'vitest'
import Anthropic from '@anthropic-ai/sdk'
import { runBillingAgent } from '../agents/billing-agent'
import { mockTextResponse, mockToolUse } from './helpers/mock-llm'
import { createMockTools } from './helpers/mock-tools'

describe('BillingAgent — routing', () => {
  let mockCreate: ReturnType<typeof vi.fn>
  let mockTools: ReturnType<typeof createMockTools>

  beforeEach(() => {
    const client = new Anthropic()
    mockCreate = client.messages.create as ReturnType<typeof vi.fn>
    mockTools = createMockTools()
  })

  it('busca al cliente antes de crear la factura', async () => {
    // LLM decide: primero buscar, luego crear
    mockCreate
      .mockResolvedValueOnce(mockToolUse('getCustomer', { id: 'c123' }))
      .mockResolvedValueOnce(mockToolUse('createInvoice', { amount: 500 }))
      .mockResolvedValueOnce(mockTextResponse('Factura creada correctamente.'))

    const result = await runBillingAgent(
      'Crea una factura por 500€ para el cliente c123',
      mockTools
    )

    expect(result.toolCallOrder).toEqual(['getCustomer', 'createInvoice'])
    expect(mockCreate).toHaveBeenCalledTimes(3)
  })
})
Este test no gasta ni un céntimo. Se ejecuta en 2ms. Y verifica algo que no puedes comprobar solo con tests de output: el orden en que el agente toma decisiones.
Testear caminos de error que nadie prueba
La parte más valiosa del mocking es que puedes provocar situaciones que en producción son raras pero devastadoras.
it('hace fallback cuando el LLM devuelve JSON inválido', async () => {
  mockCreate.mockResolvedValueOnce(
    mockTextResponse('{ "action": "create_invoice", invalid json here }')
  )

  const result = await runBillingAgent('Crea factura', mockTools)

  expect(result.status).toBe('fallback')
  expect(mockTools.email.send).not.toHaveBeenCalled() // no envió nada
})

it('reintenta cuando el LLM devuelve stop_reason: max_tokens', async () => {
  mockCreate
    .mockResolvedValueOnce({ ...mockTextResponse('...'), stop_reason: 'max_tokens' })
    .mockResolvedValueOnce(mockTextResponse('Respuesta completa.'))

  const result = await runBillingAgent('Genera un informe largo', mockTools)

  expect(result.status).toBe('success')
  expect(mockCreate).toHaveBeenCalledTimes(2) // reintentó
})
Estos caminos de error son casi imposibles de testear con la API real de forma fiable. Con mocks, son triviales y se ejecutan en milisegundos.
El número que justifica todo
Con la API real: 50 tests, 2 minutos de ejecución, $12 por run de CI. Con 20 PRs a la semana, eso son $240 semanales solo en tests — sin contar la ralentización del feedback loop para los desarrolladores.
Con mocks deterministas: 500 tests cubriendo el triple de casos, 1.2 segundos de ejecución, $0.
Los tests de integración con LLM real siguen siendo necesarios — pero son 20 tests para validar que los prompts funcionan, no 500 tests de lógica de routing que pueden correr sin API.
La arquitectura correcta no es una elección entre velocidad y confianza. Es usar cada herramienta donde tiene sentido: mocks para lógica, LLM real para prompts, LLM-as-judge para calidad.
El problema de llegar aquí tarde
La mayoría de los proyectos que vemos en DAILYMP llegan a esta infraestructura de tests cuando ya tienen un agente en producción con deuda técnica de testing. Añadir mocking a posteriori en un agente con dependencias hardcodeadas es costoso — hay que refactorizar antes de poder testear.
La arquitectura correcta se decide al principio: dependency injection para las tools, mock factories para el LLM, y los tres niveles de test desde el primer sprint.
Construirlo bien desde cero tarda un día. Reconstruirlo en un agente existente puede tardar una semana.
¿Estás construyendo un agente IA y no tienes esta infraestructura de tests? En 30 minutos te explico qué necesitas para tener una suite que puedas correr en CI sin gastar en API.